同步完整源码 - 2026-05-25
This commit is contained in:
 xiaoxue
@@ -0,0 +1,126 @@
|
||||
|
||||
# BaseParser
|
||||
|
||||
BaseParser为Spider的基类,用来定义任务下发与数据解析,是面向用户提供的接口
|
||||
|
||||
## 源码
|
||||
|
||||
|
||||
```python
|
||||
class BaseParser(object):
|
||||
def start_requests(self):
|
||||
"""
|
||||
@summary: 添加初始url
|
||||
---------
|
||||
---------
|
||||
@result: yield Request()
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def download_midware(self, request):
|
||||
"""
|
||||
@summary: 下载中间件 可修改请求的一些参数, 或可自定义下载,然后返回 request, response
|
||||
---------
|
||||
@param request:
|
||||
---------
|
||||
@result: return request / request, response
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def validate(self, request, response):
|
||||
"""
|
||||
@summary: 校验函数, 可用于校验response是否正确
|
||||
若函数内抛出异常,则重试请求
|
||||
若返回True 或 None,则进入解析函数
|
||||
若返回False,则抛弃当前请求
|
||||
可通过request.callback_name 区分不同的回调函数,编写不同的校验逻辑
|
||||
---------
|
||||
@param request:
|
||||
@param response:
|
||||
---------
|
||||
@result: True / None / False
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def parse(self, request, response):
|
||||
"""
|
||||
@summary: 默认的解析函数
|
||||
---------
|
||||
@param request:
|
||||
@param response:
|
||||
---------
|
||||
@result:
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def exception_request(self, request, response):
|
||||
"""
|
||||
@summary: 请求或者parser里解析出异常的request
|
||||
---------
|
||||
@param request:
|
||||
@param response:
|
||||
---------
|
||||
@result: request / callback / None (返回值必须可迭代)
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def failed_request(self, request, response):
|
||||
"""
|
||||
@summary: 超过最大重试次数的request
|
||||
可返回修改后的request 若不返回request,则将传进来的request直接人redis的failed表。否则将修改后的request入failed表
|
||||
---------
|
||||
@param request:
|
||||
---------
|
||||
@result: request / item / callback / None (返回值必须可迭代)
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def start_callback(self):
|
||||
"""
|
||||
@summary: 程序开始的回调
|
||||
---------
|
||||
---------
|
||||
@result: None
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
def end_callback(self):
|
||||
"""
|
||||
@summary: 程序结束的回调
|
||||
---------
|
||||
---------
|
||||
@result: None
|
||||
"""
|
||||
|
||||
pass
|
||||
|
||||
@property
|
||||
def name(self):
|
||||
return self.__class__.__name__
|
||||
|
||||
def close(self):
|
||||
pass
|
||||
```
|
||||
|
||||
## 使用
|
||||
|
||||
以程序开始结束回调举例:
|
||||
|
||||
```python
|
||||
import feapder
|
||||
|
||||
|
||||
class TestSpider(feapder.Spider):
|
||||
def start_callback(self):
|
||||
print("爬虫开始了")
|
||||
|
||||
def end_callback(self):
|
||||
print("爬虫结束了")
|
||||
```
|
||||
@@ -0,0 +1,121 @@
|
||||
# BatchParser
|
||||
|
||||
BaseParser为BatchSpider的基类,用来定义任务下发与数据解析,是面向用户提供的接口
|
||||
|
||||
除了提供[BaseParser](source_code/BaseParser)所有接口外,还提供以下方法
|
||||
|
||||
## 方法详解
|
||||
|
||||
### 1. 添加任务 add_task
|
||||
|
||||
add_task, 每次执行start_monitor都会调用,且在init_task之前调用, 用于在批次爬虫启动前添加任务到数据库
|
||||
|
||||
```
|
||||
class TestSpider(feapder.BatchSpider):
|
||||
def add_task(self):
|
||||
pass
|
||||
```
|
||||
|
||||
### 2. 更新任务
|
||||
|
||||
#### 方法一:
|
||||
|
||||
一条条更新
|
||||
|
||||
```python
|
||||
def update_task_state(self, task_id, state=1, **kwargs):
|
||||
"""
|
||||
@summary: 更新任务表中任务状态,做完每个任务时代码逻辑中要主动调用
|
||||
调用方法为 yield lambda : self.update_task_state(task_id, state)
|
||||
---------
|
||||
@param task_id: 任务id
|
||||
@param state: 任务状态
|
||||
---------
|
||||
@result:
|
||||
"""
|
||||
```
|
||||
|
||||
举例说明
|
||||
|
||||
```
|
||||
def parse(self, request, response):
|
||||
yield item # 返回item, item会自动批量入库
|
||||
yield lambda : self.update_task_state(request.task_id, 1)
|
||||
```
|
||||
|
||||
在`yield item`后,调用`self.update_task_state`函数实现任务状态更新。
|
||||
|
||||
这里为什么使用`yield lambda`方式呢?因为`yield item`后,item不会马上入库,会存在一个buffer中,批量入库,如果我们直接调用`self.update_task_state`更新任务状态,可能这时item还并未入库,如果此时程序意外退出,那么缓存中的这一部分item数据将会丢失,但是此时任务状态已更新,任务不会重做,这便会导致这个任务所对应的数据丢失
|
||||
|
||||
`yield lambda`返回的是一个回调函数,这个函数并不会马上执行,系统会保证item入库后再执行,因此这么写的用意在于item入库后再更新任务状态
|
||||
|
||||
#### 方法二:
|
||||
|
||||
批量更新
|
||||
|
||||
```python
|
||||
def update_task_batch(self, task_id, state=1, **kwargs):
|
||||
"""
|
||||
批量更新任务 多处调用,更新的字段必须一致
|
||||
注意:需要 写成 yield update_task_batch(...) 否则不会更新
|
||||
@param task_id:
|
||||
@param state:
|
||||
@param kwargs:
|
||||
@return:
|
||||
"""
|
||||
```
|
||||
|
||||
举例说明
|
||||
|
||||
```python
|
||||
def parse(self, request, response):
|
||||
yield item # 返回item, item会自动批量入库
|
||||
yield self.update_task_batch(request.task_id, 1) # 更新任务状态为1
|
||||
```
|
||||
|
||||
在`yield item`后调用`self.update_task_batch`实现批量更新
|
||||
|
||||
注意,批量更新必须使用 `yield`, 因为`update_task_batch`函数并未实现更新逻辑,只是返回了`UpdateItem`, `UpdateItem`与`Item`类似,只不过带有更新功能,框架会在Item入库后在调用`UpdateItem`实现批量更新。关于`UpdateItem`详解,请参考[UpdateItem]()
|
||||
|
||||
#### 两种方式选取
|
||||
|
||||
同一张表,若更新字段相同,推荐使用批量更新的方式,效率更高,若字段不同,用一条条更新的方式。因为批量更新,这一批的更新字段必须一致
|
||||
|
||||
比如当请求失败时,将任务更新为-1,同时标记失败原因,成功时将任务更新为1,写法如下:
|
||||
|
||||
```python
|
||||
def parse(self, request, response):
|
||||
yield self.update_task_batch(request.task_id, 1) # 更新任务状态为1
|
||||
|
||||
def failed_request(self, request, response):
|
||||
"""
|
||||
@summary: 超过最大重试次数的request
|
||||
---------
|
||||
@param request:
|
||||
---------
|
||||
@result: request / item / callback / None (返回值必须可迭代)
|
||||
"""
|
||||
|
||||
yield request
|
||||
yield lambda : self.update_task_state(request.task_id, -1, remark="失败原因") # 更新任务状态为-1
|
||||
```
|
||||
|
||||
因任务失败时多更新了个remark字段,与任务成功时只更新state字段不同,因此需要将此更新操作单独拆出来,用`update_task_state`方式更新
|
||||
|
||||
### 3. 获取批次时间
|
||||
|
||||
示例:
|
||||
|
||||
def parse(self, request, response):
|
||||
item = SpiderDataItem() # 声明一个item
|
||||
item.batch_data = self.batch_date
|
||||
item.title = title # 给item属性赋值
|
||||
yield item # 返回item, item会自动批量入库
|
||||
|
||||
使用`self.batch_date`可获取当前批次时间,然后拼接到item入库
|
||||
|
||||
数据示例
|
||||
|
||||
| id | title | batch_date |
|
||||
| --- | --- | --- |
|
||||
| 1 | 百度一下 | 2021-01-01 |
|
||||
@@ -0,0 +1,223 @@
|
||||
# BatchSpider
|
||||
|
||||
## BatchSpider参数
|
||||
|
||||
```python
|
||||
def __init__(
|
||||
self,
|
||||
task_table,
|
||||
batch_record_table,
|
||||
batch_name,
|
||||
batch_interval,
|
||||
task_keys,
|
||||
task_state="state",
|
||||
min_task_count=10000,
|
||||
check_task_interval=5,
|
||||
task_limit=10000,
|
||||
related_redis_key=None,
|
||||
related_batch_record=None,
|
||||
task_condition="",
|
||||
task_order_by="",
|
||||
redis_key=None,
|
||||
thread_count=None,
|
||||
begin_callback=None,
|
||||
end_callback=None,
|
||||
delete_keys=(),
|
||||
keep_alive=None,
|
||||
send_run_time=False,
|
||||
):
|
||||
"""
|
||||
@summary: 批次爬虫
|
||||
必要条件
|
||||
1、需有任务表
|
||||
任务表中必须有id 及 任务状态字段 如 state。如指定parser_name字段,则任务会自动下发到对应的parser下, 否则会下发到所有的parser下。其他字段可根据爬虫需要的参数自行扩充
|
||||
|
||||
参考建表语句如下:
|
||||
CREATE TABLE `table_name` (
|
||||
`id` int(11) NOT NULL AUTO_INCREMENT,
|
||||
`param` varchar(1000) DEFAULT NULL COMMENT '爬虫需要的抓取数据需要的参数',
|
||||
`state` int(11) DEFAULT NULL COMMENT '任务状态',
|
||||
`parser_name` varchar(255) DEFAULT NULL COMMENT '任务解析器的脚本类名',
|
||||
PRIMARY KEY (`id`),
|
||||
UNIQUE KEY `nui` (`param`) USING BTREE
|
||||
) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
|
||||
|
||||
2、需有批次记录表 不存在自动创建
|
||||
---------
|
||||
@param task_table: mysql中的任务表
|
||||
@param batch_record_table: mysql 中的批次记录表
|
||||
@param batch_name: 批次采集程序名称
|
||||
@param batch_interval: 批次间隔 天为单位。 如想一小时一批次,可写成1/24
|
||||
@param task_keys: 需要获取的任务字段 列表 [] 如需指定解析的parser,则需将parser_name字段取出来。
|
||||
@param task_state: mysql中任务表的任务状态字段
|
||||
@param min_task_count: redis 中最少任务数, 少于这个数量会从mysql的任务表取任务
|
||||
@param check_task_interval: 检查是否还有任务的时间间隔;
|
||||
@param task_limit: 从数据库中取任务的数量
|
||||
@param redis_key: 任务等数据存放在redis中的key前缀
|
||||
@param thread_count: 线程数,默认为配置文件中的线程数
|
||||
@param begin_callback: 爬虫开始回调函数
|
||||
@param end_callback: 爬虫结束回调函数
|
||||
@param delete_keys: 爬虫启动时删除的key,类型: 元组/bool/string。 支持正则; 常用于清空任务队列,否则重启时会断点续爬
|
||||
@param keep_alive: 爬虫是否常驻,默认否
|
||||
@param send_run_time: 发送运行时间
|
||||
@param related_redis_key: 有关联的其他爬虫任务表(redis)注意:要避免环路 如 A -> B & B -> A 。
|
||||
@param related_batch_record: 有关联的其他爬虫批次表(mysql)注意:要避免环路 如 A -> B & B -> A 。
|
||||
related_redis_key 与 related_batch_record 选其一配置即可;用于相关联的爬虫没结束时,本爬虫也不结束
|
||||
若相关连的爬虫为批次爬虫,推荐以related_batch_record配置,
|
||||
若相关连的爬虫为普通爬虫,无批次表,可以以related_redis_key配置
|
||||
@param task_condition: 任务条件 用于从一个大任务表中挑选出数据自己爬虫的任务,即where后的条件语句
|
||||
@param task_order_by: 取任务时的排序条件 如 id desc
|
||||
---------
|
||||
@result:
|
||||
"""
|
||||
```
|
||||
|
||||
下面介绍下理解起来可能有疑惑的参数
|
||||
|
||||
### 1. related_redis_key 与 related_batch_record
|
||||
|
||||
这两个参数用于采集之间有关联的爬虫,比如列表爬虫和详情爬虫,详情的任务需依赖列表爬虫生产,列表爬虫没采集完毕,详情爬虫要处于等待状态。
|
||||
|
||||
举例说明:BatchSpider依赖Spider
|
||||
|
||||
```
|
||||
|
||||
def crawl_list():
|
||||
"""
|
||||
普通爬虫 Spider
|
||||
"""
|
||||
spider = spider_test.SpiderTest(redis_key="feapder:list")
|
||||
spider.start()
|
||||
|
||||
|
||||
def crawl_detail(args):
|
||||
"""
|
||||
批次爬虫 BatchSpider
|
||||
@param args: 1 / 2 / init
|
||||
"""
|
||||
spider = batch_spider_test.BatchSpiderTest(
|
||||
task_table="list_task", # mysql中的任务表
|
||||
batch_record_table="list_batch_record", # mysql中的批次记录表
|
||||
batch_name="详情爬虫(周全)", # 批次名字
|
||||
batch_interval=7, # 批次时间 天为单位 若为小时 可写 1 / 24
|
||||
task_keys=["id", "item_id"], # 需要获取任务表里的字段名,可添加多个
|
||||
redis_key="feapder:detail", # redis中存放request等信息的根key
|
||||
task_state="state", # mysql中任务状态字段
|
||||
related_redis_key="feapder:list:z_requsets"
|
||||
)
|
||||
|
||||
if args == 1:
|
||||
spider.start_monitor_task()
|
||||
elif args == 2:
|
||||
spider.start()
|
||||
```
|
||||
|
||||
若批次爬虫和批次爬虫之间有依赖,除了设置related_redis_key参数外,还支持设置related_batch_record参数,指定对方的批次记录表即可。两个参数二选一
|
||||
|
||||
### 2. task_condition
|
||||
|
||||
取任务的条件,可以理解为sql后面的where条件。如获取url不为空的任务且id大于10的任务
|
||||
|
||||
task_condition="url is not null and id > 10"
|
||||
|
||||
|
||||
## BatchSpider方法
|
||||
|
||||
BatchSpider继承至BatchParser,并且BatchParser是对开发者暴露的常用方法接口,因此推荐先看[BatchParser](source_code/BatchParser),BatchSpider方法如下:
|
||||
|
||||
### init_task 任务初始化
|
||||
|
||||
init_task函数会在每个批次开始时调用,用于将已完成的任务状态重置为0。
|
||||
|
||||
因此当本函数被重写为空时,可实现增量抓取
|
||||
|
||||
```
|
||||
def init_task(self):
|
||||
pass
|
||||
```
|
||||
|
||||
当手动调用本函数时,可将任务状态刷新为0,开发阶段经常使用
|
||||
|
||||
spider.init_task()
|
||||
|
||||
|
||||
## 其他细节
|
||||
|
||||
### 1. 任务防丢
|
||||
|
||||
BatchSpider除了支持Spider的[任务防丢机制](source_code/Spider进阶?id=_1-任务防丢)外,还多了一层mysql任务表的保障,mysql任务表中每条任务都有任务状态,BatchSpider有任务丢失重发机制,直到所有任务都处于成功或者失败两种状态,才算采集结束。
|
||||
|
||||
### 2. 任务重试
|
||||
|
||||
> 与Spider相同
|
||||
|
||||
任务请求失败或解析函数抛出异常时,会自动重试,默认重试次数为100次,可通过配置文件`SPIDER_MAX_RETRY_TIMES`参数修改。当任务超过最大重试次数时,默认会将失败的任务存储到Redis的`{redis_key}:z_failed_requsets`里,供人工排查。
|
||||
|
||||
相关配置为:
|
||||
|
||||
```python
|
||||
# 每个请求最大重试次数
|
||||
SPIDER_MAX_RETRY_TIMES = 100
|
||||
# 重新尝试失败的requests 当requests重试次数超过允许的最大重试次数算失败
|
||||
RETRY_FAILED_REQUESTS = False
|
||||
# 保存失败的request
|
||||
SAVE_FAILED_REQUEST = True
|
||||
# 任务失败数 超过WARNING_FAILED_COUNT则报警
|
||||
WARNING_FAILED_COUNT = 1000
|
||||
```
|
||||
|
||||
当`RETRY_FAILED_REQUESTS=True`时,爬虫再次启动时会将失败的任务重新下发到任务队列中,重新抓取
|
||||
|
||||
### 3. 去重
|
||||
|
||||
> 与Spider相同
|
||||
|
||||
支持任务去重和数据去重,任务默认是临时去重,去重库保留1个月,即只去重1个月内的任务,数据是永久去重。默认去重是关闭的,相关配置为:
|
||||
|
||||
```
|
||||
ITEM_FILTER_ENABLE = False # item 去重
|
||||
REQUEST_FILTER_ENABLE = False # request 去重
|
||||
```
|
||||
|
||||
修改默认去重库:
|
||||
|
||||
```
|
||||
from feapder.buffer.request_buffer import RequestBuffer
|
||||
from feapder.buffer.item_buffer import ItemBuffer
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
RequestBuffer.dedup = Dedup(filter_type=Dedup.MemoryFilter)
|
||||
ItemBuffer.dedup = Dedup(filter_type=Dedup.MemoryFilter)
|
||||
```
|
||||
|
||||
RequestBuffer 为任务入库前缓冲的buffer,ItemBuffer为数据入库前缓冲的buffer
|
||||
|
||||
关于去重库详情见:[海量数据去重](source_code/dedup)
|
||||
|
||||
### 4. 加速采集
|
||||
|
||||
> 与Spider相同
|
||||
|
||||
与爬虫采集速度的相关配置为:
|
||||
|
||||
```python
|
||||
# 爬虫相关
|
||||
# COLLECTOR
|
||||
COLLECTOR_SLEEP_TIME = 1 # 从任务队列中获取任务到内存队列的间隔
|
||||
COLLECTOR_TASK_COUNT = 10 # 每次获取任务数量
|
||||
|
||||
# SPIDER
|
||||
SPIDER_THREAD_COUNT = 1 # 爬虫并发数
|
||||
SPIDER_SLEEP_TIME = 0 # 下载时间间隔(解析完一个response后休眠时间)
|
||||
SPIDER_MAX_RETRY_TIMES = 100 # 每个请求最大重试次数
|
||||
# 是否主动执行添加 设置为False 需要手动调用start_monitor_task,适用于多进程情况下
|
||||
|
||||
```
|
||||
|
||||
COLLECTOR 为从任务队列中取任务到内存队列的线程,SPIDER为实际采集的线程
|
||||
|
||||
`COLLECTOR_TASK_COUNT` 建议 >= `SPIDER_THREAD_COUNT`, 这样每个线程的爬虫才有任务可做。但COLLECTOR_TASK_COUNT不建议过大,不然分布式时,一个池子里的任务都被节点A取走了,其他节点取不到任务了。
|
||||
|
||||
### 了解更多
|
||||
|
||||
更多配置,详见[配置文件](source_code/配置文件)
|
||||
@@ -0,0 +1,140 @@
|
||||
# Item
|
||||
|
||||
有关Item的简介及创建,可参考[命令行工具](command/cmdline?id=_3-创建-item)
|
||||
|
||||
## 数据入库
|
||||
|
||||
数据自动入库,除了根据mysql表生产item外,也可以直接给item赋值,示例如下:
|
||||
|
||||
```
|
||||
from feapder import Item
|
||||
|
||||
item = Item()
|
||||
item.table_name = "spider_data" # 表名
|
||||
item.title = title
|
||||
yield item
|
||||
```
|
||||
|
||||
等价于:
|
||||
|
||||
1. 生成item
|
||||
|
||||
```
|
||||
from feapder import Item
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
"""
|
||||
This class was generated by feapder.
|
||||
command: feapder create -i spider_data.
|
||||
"""
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
```
|
||||
|
||||
1. 使用
|
||||
|
||||
```
|
||||
item = SpiderDataItem()
|
||||
item.title = title
|
||||
yield item
|
||||
```
|
||||
|
||||
## Item指纹
|
||||
|
||||
item指纹用于数据入库前的去重,默认为所有字段值排序后计算的md5,但当数据中有采集时间时,这种指纹计算方式明显不合理。因此我们可以通过如下方法指定参与去重的key
|
||||
|
||||
```
|
||||
from feapder import Item
|
||||
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
|
||||
__unique_key__ = ["title", "url"] # 指定去重的key为 title、url,最后的指纹为title与url值联合计算的md5
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
self.url = None
|
||||
self.crawl_time = None
|
||||
```
|
||||
|
||||
或可通过如下方式指定`__unique_key__`
|
||||
|
||||
```
|
||||
item = SpiderDataItem()
|
||||
item.unique_key = ["title", "url"] # 支持列表、元组、字符串
|
||||
```
|
||||
|
||||
或者重写指纹函数
|
||||
|
||||
```
|
||||
from feapder import Item
|
||||
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
...
|
||||
|
||||
@property
|
||||
def fingerprint(self):
|
||||
return "我是指纹"
|
||||
```
|
||||
|
||||
## 入库前对item进行处理
|
||||
|
||||
pre_to_db函数为每个item入库前的回调函数,可通过此函数对数据进行处理
|
||||
|
||||
```python
|
||||
from feapder import Item
|
||||
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
|
||||
def pre_to_db(self):
|
||||
"""
|
||||
入库前的处理
|
||||
"""
|
||||
self.title = self.title.strip()
|
||||
```
|
||||
|
||||
## 指定入库使用的pipelines
|
||||
|
||||
```python
|
||||
|
||||
from feapder import Item
|
||||
from feapder.pipelines.csv_pipeline import CsvPipeline
|
||||
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
|
||||
__pipelines__ = [CsvPipeline()]
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
```
|
||||
|
||||
使用__pipelines__指定后,该item只会流经指定的pipelines处理
|
||||
|
||||
|
||||
## 更新数据
|
||||
|
||||
采集过程中,往往会有些数据漏采或解析出错,如果我们想更新已入库的数据,可将Item转为UpdateItem
|
||||
|
||||
item = SpiderDataItem.to_UpdateItem()
|
||||
|
||||
或直接修改继承类
|
||||
|
||||
```
|
||||
from feapder import Item, UpdateItem
|
||||
|
||||
class SpiderDataItem(UpdateItem):
|
||||
...
|
||||
```
|
||||
|
||||
关于UpdateItem使用,详见[UpdateItem](source_code/UpdateItem)
|
||||
@@ -0,0 +1,152 @@
|
||||
# MongoDB
|
||||
|
||||
## 数据自动入Mongo库使用须知
|
||||
|
||||
- 使用`MongoDb`存储数据,需要使用`MongoPipeline`
|
||||
|
||||
示例:
|
||||
|
||||
```python
|
||||
import feapder
|
||||
from feapder import Item
|
||||
|
||||
|
||||
class TestMongo(feapder.AirSpider):
|
||||
__custom_setting__ = dict(
|
||||
ITEM_PIPELINES=["feapder.pipelines.mongo_pipeline.MongoPipeline"],
|
||||
MONGO_IP="localhost",
|
||||
MONGO_PORT=27017,
|
||||
MONGO_DB="feapder",
|
||||
MONGO_USER_NAME="",
|
||||
MONGO_USER_PASS="",
|
||||
)
|
||||
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com")
|
||||
|
||||
def parse(self, request, response):
|
||||
title = response.xpath("//title/text()").extract_first() # 取标题
|
||||
item = Item() # 声明一个item
|
||||
item.table_name = "test_mongo" # 指定存储的表名
|
||||
item.title = title # 给item属性赋值
|
||||
yield item # 返回item, item会自动批量入库
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestMongo().start()
|
||||
```
|
||||
|
||||
|
||||
## 直接使用
|
||||
|
||||
### 连接
|
||||
|
||||
```python
|
||||
from feapder.db.mongodb import MongoDB
|
||||
|
||||
|
||||
db = MongoDB(
|
||||
ip="localhost", port=27017, db="feapder", user_name="feapder", user_pass="feapder123"
|
||||
)
|
||||
```
|
||||
|
||||
若环境变量中配置了数据库连接方式或者setting中已配置,则可不传参
|
||||
|
||||
```python
|
||||
db = MongoDB()
|
||||
```
|
||||
|
||||
或者可以根据url连接
|
||||
|
||||
```python
|
||||
db = MongoDB.from_url("mongodb://username:password@ip:port/db")
|
||||
```
|
||||
|
||||
### 方法
|
||||
|
||||
> MongoDB封装了增删改查等方法,方便使用
|
||||
|
||||
#### 查
|
||||
|
||||
```python
|
||||
def find(self, table, limit=0) -> List[Dict]:
|
||||
"""
|
||||
@summary:
|
||||
无数据: 返回()
|
||||
有数据: 若limit == 1 则返回 (data1, data2)
|
||||
否则返回 ((data1, data2),)
|
||||
---------
|
||||
@param table:
|
||||
@param limit:
|
||||
---------
|
||||
@result:
|
||||
"""
|
||||
```
|
||||
|
||||
|
||||
#### 增
|
||||
|
||||
```python
|
||||
def add(self, table, data, **kwargs):
|
||||
"""
|
||||
|
||||
Args:
|
||||
table:
|
||||
data:
|
||||
kwargs:
|
||||
auto_update: 覆盖更新,将替换唯一索引重复的数据,默认False
|
||||
update_columns: 更新指定的列(如果数据的唯一索引存在,则更新指定字段,如 update_columns = ["name", "title"]
|
||||
insert_ignore: 唯一索引冲突时是否忽略,默认为False
|
||||
condition_fields: 用于条件查找的字段,默认以`_id`作为查找条件,默认:['_id']
|
||||
exception_callfunc: 异常回调
|
||||
|
||||
Returns: 添加行数
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
```python
|
||||
def add_batch(self, table: str, datas: List[Dict], **kwargs):
|
||||
"""
|
||||
@summary: 批量添加数据
|
||||
---------
|
||||
@param command: 字典
|
||||
@param datas: 列表 [[..], [...]]
|
||||
@param **kwargs:
|
||||
auto_update: 覆盖更新,将替换唯一索引重复的数据,默认False
|
||||
update_columns: 更新指定的列(如果数据的唯一索引存在,则更新指定字段,如 update_columns = ["name", "title"]
|
||||
update_columns_value: 指定更新的字段对应的值
|
||||
condition_fields: 用于条件查找的字段,默认以`_id`作为查找条件,默认:['_id']
|
||||
---------
|
||||
@result: 添加行数
|
||||
"""
|
||||
```
|
||||
|
||||
#### 更新
|
||||
|
||||
```python
|
||||
def update(self, coll_name, data: Dict, condition: Dict, upsert: bool = False):
|
||||
"""
|
||||
更新
|
||||
Args:
|
||||
coll_name: 集合名
|
||||
data: 单条数据 {"xxx":"xxx"}
|
||||
condition: 更新条件 {"_id": "xxxx"}
|
||||
upsert: 数据不存在则插入,默认为 False
|
||||
|
||||
Returns: True / False
|
||||
"""
|
||||
```
|
||||
|
||||
#### 删除
|
||||
|
||||
```python
|
||||
def delete(self, table, condition: Dict):
|
||||
"""
|
||||
删除
|
||||
Args:
|
||||
table:
|
||||
condition: 查找条件
|
||||
Returns: True / False
|
||||
"""
|
||||
```
|
||||
@@ -0,0 +1,146 @@
|
||||
# MysqlDB
|
||||
|
||||
MysqlDB具有断开自动重连特性,支持多线程下操作,内置连接池,最大连接数100
|
||||
|
||||
## 连接
|
||||
|
||||
```python
|
||||
from feapder.db.mysqldb import MysqlDB
|
||||
|
||||
|
||||
db = MysqlDB(
|
||||
ip="localhost", port=3306, db="feapder", user_name="feapder", user_pass="feapder123"
|
||||
)
|
||||
```
|
||||
|
||||
若环境变量中配置了数据库连接方式或者setting中已配置,则可不传参
|
||||
|
||||
```python
|
||||
db = MysqlDB()
|
||||
```
|
||||
|
||||
或者可以根据url连接
|
||||
|
||||
```python
|
||||
db = MysqlDB.from_url("mysql://username:password@ip:port/db?charset=utf8mb4")
|
||||
```
|
||||
|
||||
## 方法
|
||||
|
||||
> MysqlDB封装了增删改查等方法,方便使用
|
||||
|
||||
### 查
|
||||
|
||||
```python
|
||||
def find(self, sql, limit=0, to_json=False):
|
||||
"""
|
||||
@summary:
|
||||
无数据: 返回()
|
||||
有数据: 若limit == 1 则返回 (data1, data2)
|
||||
否则返回 ((data1, data2),)
|
||||
---------
|
||||
@param sql:
|
||||
@param limit:
|
||||
@param to_json 是否将查询结果转为json
|
||||
---------
|
||||
@result:
|
||||
"""
|
||||
```
|
||||
|
||||
|
||||
### 增
|
||||
|
||||
```python
|
||||
def add(self, sql, exception_callfunc=None):
|
||||
"""
|
||||
Args:
|
||||
sql:
|
||||
exception_callfunc: 异常回调
|
||||
|
||||
Returns:添加行数
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
```python
|
||||
def add_smart(self, table, data: Dict, **kwargs):
|
||||
"""
|
||||
添加数据, 直接传递json格式的数据,不用拼sql
|
||||
Args:
|
||||
table: 表名
|
||||
data: 字典 {"xxx":"xxx"}
|
||||
**kwargs:
|
||||
|
||||
Returns:添加行数
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
|
||||
```python
|
||||
def add_batch(self, sql, datas: List[Dict]):
|
||||
"""
|
||||
@summary: 批量添加数据
|
||||
---------
|
||||
@ param sql: insert ignore into (xxx, xxx) values (%s, %s, %s)
|
||||
@ param datas: 列表 [{}, {}, {}]
|
||||
---------
|
||||
@result:添加行数
|
||||
"""
|
||||
```
|
||||
|
||||
```python
|
||||
def add_batch_smart(self, table, datas: List[Dict], **kwargs):
|
||||
"""
|
||||
批量添加数据, 直接传递list格式的数据,不用拼sql
|
||||
Args:
|
||||
table: 表名
|
||||
datas: 列表 [{}, {}, {}]
|
||||
**kwargs:
|
||||
|
||||
Returns: 添加行数
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
### 更新
|
||||
|
||||
```python
|
||||
def update(self, sql):
|
||||
pass
|
||||
```
|
||||
|
||||
```python
|
||||
def update_smart(self, table, data: Dict, condition):
|
||||
"""
|
||||
更新, 不用拼sql
|
||||
Args:
|
||||
table: 表名
|
||||
data: 数据 {"xxx":"xxx"}
|
||||
condition: 更新条件 where后面的条件,如 condition='status=1'
|
||||
|
||||
Returns: True / False
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
### 删除
|
||||
|
||||
```python
|
||||
def delete(self, sql):
|
||||
"""
|
||||
删除
|
||||
Args:
|
||||
sql:
|
||||
|
||||
Returns: True / False
|
||||
|
||||
"""
|
||||
```
|
||||
|
||||
### 执行其他sql
|
||||
|
||||
```python
|
||||
def execute(self, sql):
|
||||
pass
|
||||
```
|
||||
@@ -0,0 +1,64 @@
|
||||
# RedisDB
|
||||
|
||||
RedisDB支持**哨兵模式**、**集群模式**与单节点的**普通模式**,封装了操作redis的常用的方法
|
||||
|
||||
## 连接
|
||||
|
||||
> 若环境变量中配置了数据库连接方式或者setting中已配置,则可不传参
|
||||
|
||||
### 普通模式
|
||||
|
||||
```python
|
||||
from feapder.db.redisdb import RedisDB
|
||||
|
||||
db = RedisDB(ip_ports="localhost:6379", db=0, user_pass=None)
|
||||
```
|
||||
|
||||
使用地址连接
|
||||
|
||||
```python
|
||||
from feapder.db.redisdb import RedisDB
|
||||
|
||||
db = RedisDB.from_url("redis://[[username]:[password]]@[host]:[port]/[db]")
|
||||
```
|
||||
|
||||
### 哨兵模式
|
||||
|
||||
```python
|
||||
from feapder.db.redisdb import RedisDB
|
||||
|
||||
db = RedisDB(ip_ports="172.25.21.4:26379,172.25.21.5:26379,172.25.21.6:26379", db=0, user_pass=None, service_name="my_master")
|
||||
```
|
||||
|
||||
注意:多个地址用逗号分隔,需传递`service_name`
|
||||
|
||||
对应setting配置文件,配置方式为:
|
||||
|
||||
```python
|
||||
REDISDB_IP_PORTS = "172.25.21.4:26379,172.25.21.5:26379,172.25.21.6:26379"
|
||||
REDISDB_USER_PASS = ""
|
||||
REDISDB_DB = 0
|
||||
REDISDB_SERVICE_NAME = "my_master"
|
||||
```
|
||||
|
||||
### 集群模式
|
||||
|
||||
```python
|
||||
from feapder.db.redisdb import RedisDB
|
||||
|
||||
db = RedisDB(ip_ports="172.25.21.4:26379,172.25.21.5:26379,172.25.21.6:26379", db=0, user_pass=None)
|
||||
```
|
||||
|
||||
注意:多个地址用逗号分隔,不用传递`service_name`
|
||||
|
||||
对应setting配置文件,配置方式为:
|
||||
|
||||
```python
|
||||
REDISDB_IP_PORTS = "172.25.21.4:26379,172.25.21.5:26379,172.25.21.6:26379"
|
||||
REDISDB_USER_PASS = ""
|
||||
REDISDB_DB = 0
|
||||
```
|
||||
|
||||
## 方法:
|
||||
|
||||
详见源码,此处不一一列举, 源码:`feapder.db.redisdb`
|
||||
@@ -0,0 +1,164 @@
|
||||
# Request
|
||||
|
||||
## 简介
|
||||
|
||||
Request为feapder的下载器,基于requests进行了封装,因此支持requests的所有参数
|
||||
|
||||
我们可以直接调用框架中的Request发起请求,使用示例:
|
||||
|
||||
```
|
||||
from feapder import Request
|
||||
|
||||
request = Request("https://www.baidu.com", data={}, params=None)
|
||||
response = request.get_response()
|
||||
print(response)
|
||||
```
|
||||
|
||||
返回的response支持xpath、css等表达式,具体用法见[Response](source_code/Response)
|
||||
|
||||
Request除了支持requests的所有参数外,更需要关心的是框架中支持的参数
|
||||
|
||||
## 参数详解
|
||||
|
||||
```python
|
||||
@summary: Request参数
|
||||
---------
|
||||
框架参数
|
||||
@param url: 待抓取url
|
||||
@param retry_times: 当前重试次数
|
||||
@param priority: 请求优先级 越小越优先 默认300
|
||||
@param parser_name: 回调函数所在的类名 默认为当前类
|
||||
@param callback: 回调函数 可以是函数 也可是函数名(如想跨类回调时,parser_name指定那个类名,callback指定那个类想回调的方法名即可)
|
||||
@param filter_repeat: 是否需要去重 (True/False) 当setting中的REQUEST_FILTER_ENABLE设置为True时该参数生效 默认True
|
||||
@param auto_request: 是否需要自动请求下载网页 默认是。设置为False时返回的response为空,需要自己去请求网页
|
||||
@param request_sync: 是否同步请求下载网页,默认异步。如果该请求url过期时间快,可设置为True,相当于yield的reqeust会立即响应,而不是去排队
|
||||
@param use_session: 是否使用session方式
|
||||
@param random_user_agent: 是否随机User-Agent (True/False) 当setting中的RANDOM_HEADERS设置为True时该参数生效 默认True
|
||||
@param download_midware: 下载中间件。默认为parser中的download_midware
|
||||
@param is_abandoned: 当发生异常时是否放弃重试 True/False. 默认False
|
||||
@param render: 是否用浏览器渲染
|
||||
@param render_time: 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
--
|
||||
以下参数于requests参数使用方式一致
|
||||
@param method: 请求方式,如POST或GET,默认根据data值是否为空来判断
|
||||
@param params: 请求参数
|
||||
@param data: 请求body
|
||||
@param json: 请求json字符串,同 json.dumps(data)
|
||||
@param headers:
|
||||
@param cookies: 字典 或 CookieJar 对象
|
||||
@param files:
|
||||
@param auth:
|
||||
@param timeout: (浮点或元组)等待服务器数据的超时限制,是一个浮点数,或是一个(connect timeout, read timeout) 元组
|
||||
@param allow_redirects : Boolean. True 表示允许跟踪 POST/PUT/DELETE 方法的重定向
|
||||
@param proxies: 代理 {"http":"http://xxx", "https":"https://xxx"}
|
||||
@param verify: 为 True 时将会验证 SSL 证书
|
||||
@param stream: 如果为 False,将会立即下载响应内容
|
||||
@param cert:
|
||||
--
|
||||
@param **kwargs: 其他值: 如 Request(item=item) 则item可直接用 request.item 取出
|
||||
---------
|
||||
```
|
||||
|
||||
举例说明:如果我们不想用内置的下载器,写法如下:
|
||||
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com", auto_request=False)
|
||||
|
||||
def parse(self, request, response):
|
||||
# response 为None, 需要自己去下载
|
||||
pass
|
||||
|
||||
|
||||
## 方法详解
|
||||
|
||||
### 1. 发起请求,获取响应
|
||||
|
||||
```
|
||||
def get_response(self, save_cached=False):
|
||||
"""
|
||||
获取带有selector功能的response
|
||||
@param save_cached: 保存缓存 方便调试时不用每次都重新下载
|
||||
@return:
|
||||
"""
|
||||
```
|
||||
|
||||
save_cached 参数用于设置是否把响应缓存到redis,若为True, 需要配置redis连接信息。redis连接信息会读取setting.py文件,所以需要保证工作区间下有setting.py。
|
||||
|
||||
或者可以将连接信息设置为环境变量
|
||||
以mac电脑为例
|
||||
|
||||
```
|
||||
> vim ~/.bash_profile
|
||||
|
||||
export REDISDB_IP_PORTS='ip:port' # 多个地址用逗号隔开
|
||||
export REDISDB_USER_PASS='xxx'
|
||||
export REDISDB_DB='xxx' # 默认是0, 可不设置
|
||||
export REDISDB_SERVICE_NAME='xxx' # 用于redis的哨兵模式,单节点或集群模式可不设置
|
||||
|
||||
```
|
||||
|
||||
这样,当框架读取不到setting时,便会取环境变量里的值
|
||||
|
||||
### 2. 从缓存中取响应
|
||||
|
||||
```
|
||||
def get_response_from_cached(self, save_cached=True):
|
||||
pass
|
||||
```
|
||||
|
||||
用于从上面的缓存中取response。当缓存不存在时,会先下载,然后将响应存入缓存,之后再返回响应。缓存同样依赖redis,因此需要先配置好redis连接信息
|
||||
|
||||
### 3. 删除缓存
|
||||
|
||||
```
|
||||
def del_response_cached(self)
|
||||
pass
|
||||
```
|
||||
|
||||
### 4. 复制Request
|
||||
|
||||
```
|
||||
def copy(self):
|
||||
pass
|
||||
```
|
||||
|
||||
## 缓存机制
|
||||
|
||||
### 1. 缓存有效期
|
||||
|
||||
缓存使用redis的str结构存储,每条缓存对应一个key,默认有效期20分钟,可以通过 `Request.cached_expire_time=过期时间`来设置
|
||||
|
||||
### 2. 缓存key
|
||||
|
||||
默认的key为 `response_cached:test:request指纹`
|
||||
|
||||
可通过`Request.cached_redis_key`设置,设置后为 `response_cached:自定义的key:request指纹`
|
||||
|
||||
## 代理及UserAgent
|
||||
|
||||
代理及UA的设置优先取传递的参数,若参数没指定,则依赖`setting.py`的配置,默认如下:
|
||||
|
||||
```python
|
||||
# 设置代理
|
||||
PROXY_EXTRACT_API = None # 代理提取API ,返回的代理分割符为\r\n
|
||||
PROXY_ENABLE = True
|
||||
|
||||
# 随机headers
|
||||
RANDOM_HEADERS = True
|
||||
# requests 使用session
|
||||
USE_SESSION = False
|
||||
```
|
||||
|
||||
PROXY_EXTRACT_API 为代理的提取地址,如
|
||||
|
||||
```python
|
||||
PROXY_EXTRACT_API="http://xxxx"
|
||||
```
|
||||
|
||||
返回的代理格式为:
|
||||
|
||||
```
|
||||
ip:port
|
||||
ip:port
|
||||
ip:port
|
||||
```
|
||||
@@ -0,0 +1,265 @@
|
||||
|
||||
|
||||
# Response
|
||||
|
||||
Response 对 requests 返回的response进行了封装,因此支持response所有方法
|
||||
|
||||
## 功能点
|
||||
|
||||
### 1. 智能解码
|
||||
|
||||
Response 对返回的文本进行了智能解码,可解决绝大多数乱码问题
|
||||
|
||||
### 2. 智能转为绝对连接
|
||||
|
||||
若网页源码里的连接是相对连接,会自动转为绝对连接
|
||||
|
||||
### 3. 支持xpath选择器
|
||||
|
||||
例如:
|
||||
|
||||
定位a标签连接,返回SelectorList
|
||||
```python
|
||||
response.xpath("//a/@href")
|
||||
```
|
||||
|
||||
取第一个连接文本
|
||||
|
||||
```python
|
||||
response.xpath("//a/@href").extract_first()
|
||||
```
|
||||
|
||||
取全部连接文本列表
|
||||
```python
|
||||
response.xpath("//a/@href").extract()
|
||||
```
|
||||
|
||||
### 4. 支持css选择器
|
||||
|
||||
例如:
|
||||
|
||||
定位a标签连接,返回SelectorList
|
||||
```python
|
||||
response.css("a::attr(href)")
|
||||
```
|
||||
|
||||
取第一个连接文本
|
||||
|
||||
```python
|
||||
response.css("a::attr(href)").extract_first()
|
||||
```
|
||||
|
||||
取全部连接文本列表
|
||||
```python
|
||||
response.css("a::attr(href)").extract()
|
||||
```
|
||||
|
||||
### 5. 支持正则
|
||||
|
||||
获取全部
|
||||
```python
|
||||
def re(self, regex, replace_entities=False):
|
||||
"""
|
||||
@summary: 正则匹配
|
||||
---------
|
||||
@param regex: 正则或者re.compile
|
||||
@param replace_entities: 为True时 去掉 等字符, 转义"为 " 等, 会使网页结构发生变化。如在网页源码中提取json, 建议设置成False
|
||||
---------
|
||||
@result: 列表
|
||||
"""
|
||||
```
|
||||
|
||||
获取第一个
|
||||
```python
|
||||
def re_first(self, regex, default=None, replace_entities=False):
|
||||
"""
|
||||
@summary: 正则匹配
|
||||
---------
|
||||
@param regex: 正则或者re.compile
|
||||
@param default: 未匹配到, 默认值
|
||||
@param replace_entities: 为True时 去掉 等字符, 转义"为 " 等, 会使网页结构发生变化。如在网页源码中提取json, 建议设置成False
|
||||
---------
|
||||
@result: 第一个值或默认值
|
||||
"""
|
||||
```
|
||||
|
||||
例如获取全部连接:
|
||||
|
||||
```
|
||||
response.re("<a.*?href='(.*?)'")
|
||||
```
|
||||
|
||||
### 6. 支持BeautifulSoup
|
||||
|
||||
默认的features为`html.parser`
|
||||
|
||||
```python
|
||||
def bs4(self, features="html.parser"):
|
||||
pass
|
||||
```
|
||||
|
||||
例如获取标题:
|
||||
|
||||
```python
|
||||
response.bs4().title
|
||||
```
|
||||
|
||||
|
||||
### 7. 定位混用
|
||||
|
||||
xpath、css两种定位方式可混用,如:
|
||||
|
||||
```
|
||||
response.css("a").xpath("./@href").extract()
|
||||
```
|
||||
|
||||
### 8. 取文本
|
||||
|
||||
取文本有两种方式
|
||||
|
||||
方式1:这种直接取的源码
|
||||
|
||||
```
|
||||
response.text
|
||||
```
|
||||
|
||||
方式2:这种会将源码转为dom树,然后获取转换之后的文本
|
||||
|
||||
```
|
||||
response.extract()
|
||||
```
|
||||
|
||||
如:网页源码`<a class='page-numbers'...` 会被处理成`<a class="page-numbers"`
|
||||
|
||||
### 9. 取json
|
||||
|
||||
```
|
||||
response.json
|
||||
```
|
||||
|
||||
### 10. 查看下载内容
|
||||
|
||||
```
|
||||
response.open()
|
||||
```
|
||||
|
||||
这个函数会打开浏览器,渲染下载内容,方便查看下载内容是否与数据源一致
|
||||
|
||||
### 11. 更新response.text的值
|
||||
|
||||
```
|
||||
response.text = ""
|
||||
```
|
||||
常用于浏览器渲染模式,如页面有变化,可以取最新的页面内容更新到response.text里,然后使用response的选择器提取内容
|
||||
|
||||
### 12. 将普通response转为feapder.Response
|
||||
|
||||
```
|
||||
response = feapder.Response(response)
|
||||
```
|
||||
|
||||
### 13. 将源码转为feapder.Response
|
||||
|
||||
```
|
||||
response = feapder.Response.from_text(text=html, url="", cookies={}, headers={})
|
||||
```
|
||||
|
||||
url是网页的地址,用来将html里的链接转为绝对链接,若不提供,则无法转换
|
||||
|
||||
示例:
|
||||
```
|
||||
import feapder
|
||||
|
||||
html = "<a href='/666'>hello word</a>"
|
||||
response = feapder.Response.from_text(text=html, url="https://www.feapder.com", cookies={}, headers={})
|
||||
print(response.xpath("//a/@href").extract_first())
|
||||
|
||||
输出:https://www.feapder.com/666
|
||||
```
|
||||
|
||||
### 14. 序列化与反序列化
|
||||
|
||||
序列化
|
||||
|
||||
response_dict = response.to_dict
|
||||
|
||||
反序列化
|
||||
|
||||
feapder.Response.from_dict(response_dict)
|
||||
|
||||
|
||||
### 其他
|
||||
|
||||
其他方法与requests的response一致,但有如下差异
|
||||
|
||||
## 差异
|
||||
|
||||
feapder.Response 与 requests的response有以下几点差异,使用时需要注意
|
||||
|
||||
### 1. json方法
|
||||
|
||||
获取json数据时,常规的response写法如下:
|
||||
|
||||
```
|
||||
response.json()
|
||||
```
|
||||
|
||||
feapder.Response写法如下
|
||||
|
||||
```
|
||||
response.json
|
||||
```
|
||||
|
||||
做到了与response.text使用方式保持一致
|
||||
|
||||
### 2. 设置编码
|
||||
|
||||
常规的response写法如下:
|
||||
|
||||
```
|
||||
response.enconding="utf-8"
|
||||
```
|
||||
|
||||
feapder.Response写法如下
|
||||
```
|
||||
response.code="utf-8"
|
||||
```
|
||||
做了简化,不过`response.enconding`也支持
|
||||
|
||||
### 3. 解码方式(二进制转字符串方式)
|
||||
|
||||
|
||||
解码方式有3种 `strict`、`replace`、`ignore`
|
||||
|
||||
1. strict:严格模式,一旦有某个字符解不出来,就会报错
|
||||
2. replace:替换模式,某个字符解不出来时,替换为乱码字符
|
||||
3. ignore:忽略模式,某个字符解不出来时,忽略这个字符
|
||||
|
||||
例如:
|
||||
|
||||
```shell
|
||||
>>>content = b'\xe4\x3f\xa0\xe5\xa5\xbd'
|
||||
>>>str(content, errors='replace')
|
||||
'�?�好'
|
||||
>>>str(content, errors='strict')
|
||||
Traceback (most recent call last):
|
||||
File "/Users/Boris/workspace/feapder/venv2/lib/python3.6/site-packages/IPython/core/interactiveshell.py", line 3343, in run_code
|
||||
exec(code_obj, self.user_global_ns, self.user_ns)
|
||||
File "<ipython-input-11-a129a2aa6283>", line 1, in <module>
|
||||
str(content, errors='strict')
|
||||
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xe4 in position 0: invalid continuation byte
|
||||
>>>str(content, errors='ignore')
|
||||
'?好'
|
||||
```
|
||||
|
||||
常规的response在解码时,使用了`replace`模式,这样会导致数据中可能混杂着乱码,我们不能及时发现.
|
||||
|
||||
feapder.Response默认使用了`strict`默认,一旦某个字符解析失败,就会抛异常,防止乱码混入。然后通过人工指定编码,解决乱码问题。
|
||||
|
||||
若想修改feapder.Response的解码方式,可通过如下方式指定
|
||||
|
||||
```
|
||||
response.encoding_errors = "strict" # strict / replace / ignore
|
||||
```
|
||||
|
||||
|
||||
@@ -0,0 +1,229 @@
|
||||
# Spider进阶
|
||||
|
||||
## Spider参数:
|
||||
|
||||
```python
|
||||
def __init__(
|
||||
self,
|
||||
redis_key=None,
|
||||
min_task_count=1,
|
||||
check_task_interval=5,
|
||||
thread_count=None,
|
||||
begin_callback=None,
|
||||
end_callback=None,
|
||||
delete_keys=(),
|
||||
keep_alive=None,
|
||||
auto_start_requests=None,
|
||||
send_run_time=False,
|
||||
batch_interval=0,
|
||||
wait_lock=True
|
||||
):
|
||||
"""
|
||||
@param redis_key: 任务等数据存放在redis中的key前缀
|
||||
@param min_task_count: 任务队列中最少任务数, 少于这个数量才会添加任务,默认1。start_monitor_task 模式下生效
|
||||
@param check_task_interval: 检查是否还有任务的时间间隔;默认5秒
|
||||
@param thread_count: 线程数,默认为配置文件中的线程数
|
||||
@param begin_callback: 爬虫开始回调函数
|
||||
@param end_callback: 爬虫结束回调函数
|
||||
@param delete_keys: 爬虫启动时删除的key,类型: 元组/bool/string。 支持正则; 常用于清空任务队列,否则重启时会断点续爬
|
||||
@param keep_alive: 爬虫是否常驻
|
||||
@param auto_start_requests: 爬虫是否自动添加任务
|
||||
@param send_run_time: 发送运行时间
|
||||
@param batch_interval: 抓取时间间隔 默认为0 天为单位 多次启动时,只有当前时间与第一次抓取结束的时间间隔大于指定的时间间隔时,爬虫才启动
|
||||
@param wait_lock: 下发任务时否等待锁,若不等待锁,可能会存在多进程同时在下发一样的任务,因此分布式环境下请将该值设置True
|
||||
"""
|
||||
|
||||
```
|
||||
|
||||
下面介绍下理解起来可能有疑惑的参数
|
||||
|
||||
### 1. redis_key
|
||||
|
||||
redis_key为redis中存储任务等信息的key前缀,如redis_key="feapder:spider_test", 则redis中会生成如下
|
||||
|
||||

|
||||
|
||||
key的命名方式为[配置文件](source_code/配置文件.md)中定义的
|
||||
|
||||
# 任务表模版
|
||||
TAB_REQUESTS = "{redis_key}:z_requsets"
|
||||
# 任务失败模板
|
||||
TAB_FAILED_REQUESTS = "{redis_key}:z_failed_requsets"
|
||||
# 爬虫状态表模版
|
||||
TAB_SPIDER_STATUS = "{redis_key}:z_spider_status"
|
||||
# item 表模版
|
||||
TAB_ITEM = "{redis_key}:s_{item_name}"
|
||||
# 爬虫时间记录表
|
||||
TAB_SPIDER_TIME = "{redis_key}:h_spider_time"
|
||||
|
||||
|
||||
### 2. min_task_count
|
||||
|
||||
这个参数用于控制最小任务数的,少于这个数量再下发任务,防止redis中堆积任务太多,内存撑爆,通常用于从数据库中取任务,下发。
|
||||
|
||||
此参数需要使用`start_monitor_task`方式才会生效,示例如下:
|
||||
|
||||
```python
|
||||
import feapder
|
||||
from feapder.db.mysqldb import MysqlDB
|
||||
|
||||
|
||||
class SpiderTest(feapder.Spider):
|
||||
def __init__(self, *args, **kwargs):
|
||||
super().__init__(*args, **kwargs)
|
||||
self.db = MysqlDB()
|
||||
|
||||
def start_requests(self):
|
||||
sql = "select url from feapder_test where state = 0 limit 1000"
|
||||
result = self.db.find(sql)
|
||||
for url, in result:
|
||||
yield feapder.Request(url)
|
||||
|
||||
def parser(self, request, response):
|
||||
print(response)
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
spider = SpiderTest(
|
||||
redis_key="feapder:spider_test", min_task_count=100
|
||||
)
|
||||
# 监控任务,若任务数小于min_task_count,则调用start_requests下发一批,注start_requests产生的任务会一次下发完,比如本例,会一次下发1000个任务,然后任务队列中少于100条任务时,再下发1000条
|
||||
spider.start_monitor_task()
|
||||
# 采集
|
||||
# spider.start()
|
||||
```
|
||||
|
||||
`spider.start_monitor_task()` 与 `spider.start()` 分开运行,属于master、worker两种进程
|
||||
|
||||
### 3. delete_keys
|
||||
|
||||
通常在开发阶段使用,如想清空任务队列重新抓取,或防止由于任务防丢策略导致爬虫需等待10分钟才能取到任务的情况。使用场景见[运行问题](question/运行问题?id=_1-二次运行时卡住,不继续抓取)
|
||||
|
||||
delete_keys 接收类型为tuple/bool/string,支持正则,拿以下的key举例
|
||||
|
||||

|
||||
|
||||
删除`feapder:spider_test_z_requests` 可写为 `delete_keys="*z_requests"`
|
||||
|
||||
删除全部可写为`delete_keys="*"`
|
||||
|
||||
### 4. keep_alive
|
||||
|
||||
用于`spider.start_monitor_task()` 与 `spider.start()` 这种master、worker模式。
|
||||
|
||||
`keep_alive=True`时,爬虫做完任务后不会退出,继续等待任务。
|
||||
|
||||
### 5. send_run_time
|
||||
|
||||
是否将运行时间作为报警信息发送
|
||||
|
||||
### 6. batch_interval
|
||||
|
||||
设置每次采集的时间间隔,如我们设置7天,当爬虫正常结束后,7天内我们二次运行爬虫时会自动退出,不执行采集逻辑
|
||||
|
||||
```
|
||||
def spider_test():
|
||||
spider = test_spider.TestSpider(redis_key="feapder:test_spider", batch_interval=7)
|
||||
spider.start()
|
||||
|
||||
```
|
||||
运行:
|
||||
|
||||
上次运行结束时间为 2021-03-15 14:42:31 与当前时间间隔 为 3秒, 小于规定的抓取时间间隔 7天。爬虫不执行,退出~
|
||||
|
||||
## Spider方法
|
||||
|
||||
Spider继承至BaseParser,并且BaseParser是对开发者暴露的常用方法接口,因此推荐先看[BaseParser](source_code/BaseParser),Spider方法如下:
|
||||
|
||||
### 1. start_monitor_task
|
||||
|
||||
下发及监控任务,与`keep_alive`参数配合使用,用于常驻进程的爬虫
|
||||
|
||||
使用:
|
||||
|
||||
spider = test_spider.TestSpider(redis_key="feapder:test_spider", keep_alive=True)
|
||||
# 下发及监控任务
|
||||
spider.start_monitor_task()
|
||||
# 采集(进程常驻)
|
||||
# spider.start()
|
||||
|
||||
`spider.start_monitor_task()` 与 `spider.start()` 分开运行,属于master、worker两种进程
|
||||
|
||||
## 其他细节
|
||||
|
||||
### 1. 任务防丢
|
||||
|
||||
Spider爬虫支持任务防丢,断点续爬,实现原理如下:
|
||||
|
||||
Spider利用了redis有序集合来存储任务,有序集合有个分数,爬虫取任务时,只取小于当前时间戳分数的任务,同时将任务分数修改为当前时间戳+10分钟,(这个取任务与改分数是原子性的操作)。**当任务做完时,且数据已入库后,再主动将任务删除。**
|
||||
|
||||
目的:将取到的任务分数修改成10分钟后,可防止其他爬虫节点取到同样的任务,同时当爬虫意外退出后,任务也不会丢失,10分钟后还可以取到。
|
||||
|
||||
10分钟是可配置的,为配置文件中的`REQUEST_LOST_TIMEOUT`参数
|
||||
|
||||
### 2. 任务重试
|
||||
|
||||
任务请求失败或解析函数抛出异常时,会自动重试,默认重试次数为100次,可通过配置文件`SPIDER_MAX_RETRY_TIMES`参数修改。当任务超过最大重试次数时,默认会将失败的任务存储到Redis的`{redis_key}:z_failed_requsets`里,供人工排查。
|
||||
|
||||
相关配置为:
|
||||
|
||||
```python
|
||||
# 每个请求最大重试次数
|
||||
SPIDER_MAX_RETRY_TIMES = 100
|
||||
# 重新尝试失败的requests 当requests重试次数超过允许的最大重试次数算失败
|
||||
RETRY_FAILED_REQUESTS = False
|
||||
# 保存失败的request
|
||||
SAVE_FAILED_REQUEST = True
|
||||
# 任务失败数 超过WARNING_FAILED_COUNT则报警
|
||||
WARNING_FAILED_COUNT = 1000
|
||||
```
|
||||
|
||||
当`RETRY_FAILED_REQUESTS=True`时,爬虫再次启动时会将失败的任务重新下发到任务队列中,重新抓取
|
||||
|
||||
### 3. 去重
|
||||
|
||||
支持任务去重和数据去重,任务默认是临时去重,去重库保留1个月,即只去重1个月内的任务,数据是永久去重。默认去重是关闭的,相关配置为:
|
||||
|
||||
```
|
||||
ITEM_FILTER_ENABLE = False # item 去重
|
||||
REQUEST_FILTER_ENABLE = False # request 去重
|
||||
```
|
||||
|
||||
修改默认去重库:
|
||||
|
||||
```
|
||||
from feapder.buffer.request_buffer import RequestBuffer
|
||||
from feapder.buffer.item_buffer import ItemBuffer
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
RequestBuffer.dedup = Dedup(filter_type=Dedup.MemoryFilter)
|
||||
ItemBuffer.dedup = Dedup(filter_type=Dedup.MemoryFilter)
|
||||
```
|
||||
|
||||
RequestBuffer 为任务入库前缓冲的buffer,ItemBuffer为数据入库前缓冲的buffer
|
||||
|
||||
关于去重库详情见:[海量数据去重](source_code/dedup)
|
||||
|
||||
### 4. 加速采集
|
||||
|
||||
与爬虫采集速度的相关配置为:
|
||||
|
||||
```python
|
||||
# 爬虫相关
|
||||
# COLLECTOR
|
||||
COLLECTOR_SLEEP_TIME = 1 # 从任务队列中获取任务到内存队列的间隔
|
||||
COLLECTOR_TASK_COUNT = 10 # 每次获取任务数量
|
||||
|
||||
# SPIDER
|
||||
SPIDER_THREAD_COUNT = 1 # 爬虫并发数
|
||||
SPIDER_SLEEP_TIME = 0 # 下载时间间隔(解析完一个response后休眠时间)
|
||||
SPIDER_MAX_RETRY_TIMES = 100 # 每个请求最大重试次数
|
||||
```
|
||||
|
||||
COLLECTOR 为从任务队列中取任务到内存队列的线程,SPIDER为实际采集的线程
|
||||
|
||||
`COLLECTOR_TASK_COUNT` 建议 >= `SPIDER_THREAD_COUNT`, 这样每个线程的爬虫才有任务可做。但COLLECTOR_TASK_COUNT不建议过大,不然分布式时,一个池子里的任务都被节点A取走了,其他节点取不到任务了。
|
||||
|
||||
### 了解更多
|
||||
|
||||
更多配置,详见[配置文件](source_code/配置文件)
|
||||
@@ -0,0 +1,73 @@
|
||||
# UpdateItem
|
||||
|
||||
UpdateItem用于更新数据,继承至Item,所以使用方式基本与Item一致,下面只说不同之处
|
||||
|
||||
## 更新逻辑
|
||||
|
||||
更新逻辑借助了数据库的唯一索引,即插入数据时发现数据已存在,则更新。因此要求数据表必须存在唯一索引,才能使用UpdateItem
|
||||
|
||||
比如将title设置唯一,要求每条数据的title都不能重复
|
||||
|
||||

|
||||
|
||||
或联合索引,要求title与url不能同时重复
|
||||
|
||||

|
||||
|
||||
|
||||
## 指定更新的字段
|
||||
|
||||
方式1:指定`__update_key__`
|
||||
|
||||
```python
|
||||
from feapder import UpdateItem
|
||||
|
||||
|
||||
class SpiderDataItem(UpdateItem):
|
||||
|
||||
__update_key__ = ["title"] # 更新title字段
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
self.url = None
|
||||
```
|
||||
|
||||
方式2:赋值`update_key`
|
||||
|
||||
```python
|
||||
from feapder import UpdateItem
|
||||
|
||||
|
||||
class SpiderDataItem(UpdateItem):
|
||||
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
self.url = None
|
||||
|
||||
item = SpiderDataItem()
|
||||
item.update_key = "title" # 支持列表、元组、字符串
|
||||
```
|
||||
|
||||
方式3:将普通的item转为UpdateItem,然后再指定更新的key
|
||||
|
||||
```python
|
||||
from feapder import Item
|
||||
|
||||
|
||||
class SpiderDataItem(Item):
|
||||
|
||||
|
||||
def __init__(self, *args, **kwargs):
|
||||
# self.id = None
|
||||
self.title = None
|
||||
self.url = None
|
||||
|
||||
item = SpiderDataItem()
|
||||
item = item.to_UpdateItem()
|
||||
item.update_key = "title"
|
||||
```
|
||||
|
||||
**推荐方式1,直接改Item类,不用修改爬虫代码**
|
||||
@@ -0,0 +1,225 @@
|
||||
# 用户池使用说明
|
||||
|
||||
用户池分为三种,使用场景如下
|
||||
1. `GuestUserPool`:游客用户池,用于从不需要登录的页面获取cookie
|
||||
2. `NormalUserPool`:普通用户池,管理大量账号的信息,从需要登录的页面获取cookie
|
||||
3. `GoldUserPool`:昂贵的用户池,用于账号单价较高,需要限制使用频率、使用时间的场景
|
||||
|
||||
## GuestUserPool使用方式
|
||||
> 环境:redis
|
||||
|
||||
### 导包
|
||||
```
|
||||
from typing import Optional
|
||||
|
||||
from feapder.network.user_pool import GuestUser
|
||||
from feapder.network.user_pool import GuestUserPool
|
||||
```
|
||||
|
||||
### 默认的用户池
|
||||
使用webdriver访问page_url生产cookie
|
||||
```
|
||||
user_pool = GuestUserPool(
|
||||
"test:user_pool", page_url="https://www.baidu.com"
|
||||
)
|
||||
|
||||
```
|
||||
|
||||
### 自定义登录方法
|
||||
```
|
||||
class CustomGuestUserPool(GuestUserPool):
|
||||
def login(self) -> Optional[GuestUser]:
|
||||
# 此处为假数据,正常需通过网站获取cookie
|
||||
user = GuestUser(
|
||||
user_agent="xxx",
|
||||
proxies="yyy",
|
||||
cookies={"some_key": "some_value{}".format(time.time())},
|
||||
)
|
||||
return user
|
||||
|
||||
user_pool = CustomGuestUserPool(
|
||||
"test:user_pool", min_users=10, keep_alive=True
|
||||
)
|
||||
```
|
||||
|
||||
### 获取用户
|
||||
无用户时会先登录生产用户
|
||||
```
|
||||
user = user_pool.get_user(block=True)
|
||||
print("取到user:", user)
|
||||
print("cookie:", user.cookies)
|
||||
print("user_agent:", user.user_agent)
|
||||
print("proxies:", user.proxies)
|
||||
|
||||
```
|
||||
### 删除用户
|
||||
```
|
||||
user_pool.del_user(user.user_id)
|
||||
```
|
||||
|
||||
### 维护一定数量的用户
|
||||
run方法需单独起一个进程调用,此进程会常驻,当用户数不足时会及时补充
|
||||
```
|
||||
user_pool.run()
|
||||
```
|
||||
|
||||
## NormalUserPool使用方式
|
||||
> 环境:redis、mysql
|
||||
|
||||
### 导包
|
||||
```
|
||||
from feapder.network.user_pool import NormalUser
|
||||
from feapder.network.user_pool import NormalUserPool
|
||||
```
|
||||
|
||||
### 自定义登录的方法
|
||||
```
|
||||
class CustomNormalUserPool(NormalUserPool):
|
||||
def login(self, user: NormalUser) -> NormalUser:
|
||||
# 此处为假数据,正常需通过登录网站获取cookie
|
||||
username = user.username
|
||||
password = user.password
|
||||
|
||||
# 登录获取cookie
|
||||
cookie = "xxx"
|
||||
user.cookies = cookie
|
||||
|
||||
return user
|
||||
|
||||
user_pool = CustomNormalUserPool(
|
||||
"test:user_pool",
|
||||
table_userbase="test_userbase",
|
||||
login_retry_times=0,
|
||||
keep_alive=True,
|
||||
)
|
||||
```
|
||||
- table_userbase 为mysql里存储用户信息的表,此表会自动创建,需手动录入用户账密
|
||||
|
||||
例如:
|
||||
|
||||

|
||||
|
||||
|
||||
|
||||
### 获取用户
|
||||
无用户时会先登录生产用户
|
||||
```
|
||||
user = user_pool.get_user()
|
||||
print("取到user:", user)
|
||||
print("cookie:", user.cookies)
|
||||
print("user_agent:", user.user_agent)
|
||||
print("proxies:", user.proxies)
|
||||
|
||||
```
|
||||
### 删除用户
|
||||
```
|
||||
user_pool.del_user(user.user_id)
|
||||
```
|
||||
|
||||
### 维护一定数量的用户
|
||||
run方法需单独起一个进程调用,此进程会常驻,当用户数不足时会及时补充
|
||||
```
|
||||
user_pool.run()
|
||||
```
|
||||
|
||||
### 标记账号被封
|
||||
以后不再使用
|
||||
```
|
||||
user_pool.tag_user_locked(user.user_id)
|
||||
```
|
||||
|
||||
## GoldUserPool使用方式
|
||||
> 环境:redis
|
||||
|
||||
### 导包
|
||||
```
|
||||
from feapder.network.user_pool import GoldUser
|
||||
from feapder.network.user_pool import GoldUserPool
|
||||
```
|
||||
|
||||
### 定义用户信息
|
||||
```
|
||||
users = [
|
||||
GoldUser(
|
||||
username="zhangsan",
|
||||
password="1234",
|
||||
max_use_times=10,
|
||||
use_interval=5,
|
||||
),
|
||||
GoldUser(
|
||||
username="lisi",
|
||||
password="1234",
|
||||
max_use_times=10,
|
||||
use_interval=5,
|
||||
login_interval=50,
|
||||
),
|
||||
]
|
||||
```
|
||||
|
||||
### 自定义登录的方法
|
||||
```
|
||||
class CustomGoldUserPool(GoldUserPool):
|
||||
def login(self, user: GoldUser) -> GoldUser:
|
||||
# 此处为假数据,正常需通过登录网站获取cookie
|
||||
username = user.username
|
||||
password = user.password
|
||||
|
||||
# 登录获取cookie
|
||||
cookie = "zzzz"
|
||||
user.cookies = cookie
|
||||
|
||||
return user
|
||||
|
||||
user_pool = CustomGoldUserPool(
|
||||
"test:user_pool",
|
||||
users=users,
|
||||
keep_alive=True,
|
||||
)
|
||||
```
|
||||
|
||||
### 获取用户
|
||||
无用户时会先登录生产用户
|
||||
```
|
||||
user = user_pool.get_user()
|
||||
print("取到user:", user)
|
||||
print("cookie:", user.cookies)
|
||||
print("user_agent:", user.user_agent)
|
||||
print("proxies:", user.proxies)
|
||||
|
||||
```
|
||||
|
||||
### 获取指定用户
|
||||
无用户时会先登录生产用户
|
||||
```
|
||||
user = user_pool.get_user(username="用户名")
|
||||
print("取到user:", user)
|
||||
print("cookie:", user.cookies)
|
||||
print("user_agent:", user.user_agent)
|
||||
print("proxies:", user.proxies)
|
||||
|
||||
```
|
||||
|
||||
### 删除用户
|
||||
```
|
||||
user_pool.del_user(user.user_id)
|
||||
```
|
||||
|
||||
### 维护一定数量的用户
|
||||
run方法需单独起一个进程调用,此进程会常驻,当用户数不足时会及时补充
|
||||
```
|
||||
user_pool.run()
|
||||
```
|
||||
|
||||
### 用户延时使用
|
||||
```
|
||||
user_pool.delay_use(user.user_id, delay_seconds)
|
||||
```
|
||||
|
||||
### 用户独占使用
|
||||
某个用户被指定的爬虫独占使用,独占时间内其他爬虫不可使用
|
||||
```
|
||||
user = user_pool.get_user(
|
||||
username="用户名",
|
||||
used_for_spider_name="爬虫名"
|
||||
)
|
||||
```
|
||||
@@ -0,0 +1,300 @@
|
||||
# 自定义下载器
|
||||
|
||||
下载器一共分为三种:**普通下载器**、**支持保持session的下载器**以及**浏览器渲染下载器**。默认已经在框架中内置,setting中的配置如下
|
||||
|
||||
```
|
||||
DOWNLOADER = "feapder.network.downloader.RequestsDownloader" # 请求下载器
|
||||
SESSION_DOWNLOADER = "feapder.network.downloader.RequestsSessionDownloader"
|
||||
RENDER_DOWNLOADER = "feapder.network.downloader.SeleniumDownloader" # 渲染下载器
|
||||
```
|
||||
|
||||
- session下载器当配置中`USE_SESSION = True`时会启用
|
||||
- 渲染下载器当使用浏览器下载功能时会启用
|
||||
|
||||
这些下载器均为插件的形式,我们可以自定义
|
||||
|
||||
## 自定义普通下载器
|
||||
|
||||
1. 编写下载器。如在 `xxx-spider/downloader/my_downloader.py `下自定义了如下下载器
|
||||
|
||||
```
|
||||
import requests
|
||||
|
||||
from feapder.network.downloader.base import Downloader
|
||||
from feapder.network.response import Response
|
||||
|
||||
class RequestsDownloader(Downloader):
|
||||
def download(self, request) -> Response:
|
||||
response = requests.request(
|
||||
request.method, request.url, **request.requests_kwargs
|
||||
)
|
||||
# 将requests的response转化为feapder的Response 对象,方便后续解析时使用xpath、re等方法
|
||||
response = Response(response)
|
||||
return response
|
||||
```
|
||||
|
||||
注:这里返回的response对象不强制要求为是feapder的Response。返回值会传到解析函数的response参数里,若返回的是文本,则接收到的也是文本。
|
||||
|
||||
但为了代码可读性,建议将返回值转为feapder的Response后再返回。
|
||||
|
||||
转feapder的Response的方式有如下几种
|
||||
|
||||
```
|
||||
# 方式1
|
||||
# response参数为reqeusts的response
|
||||
Response(response)
|
||||
|
||||
# 方式2
|
||||
Response.from_text(text="html内容")
|
||||
```
|
||||
|
||||
2. 在settings中指定下载器
|
||||
|
||||
```
|
||||
DOWNLOADER = "downloader.my_downloader.RequestsDownloader"
|
||||
```
|
||||
|
||||
## 自定义session下载器
|
||||
|
||||
1. 和普通下载器一样,都是继承`Downloader`,如何保持session,可自定义。代码示例 `xxx-spider/downloader/my_downloader.py `
|
||||
|
||||
```
|
||||
class RequestsSessionDownloader(Downloader):
|
||||
session = None
|
||||
|
||||
@property
|
||||
def _session(self):
|
||||
if not self.__class__.session:
|
||||
self.__class__.session = requests.Session()
|
||||
# pool_connections – 缓存的 urllib3 连接池个数 pool_maxsize – 连接池中保存的最大连接数
|
||||
http_adapter = HTTPAdapter(pool_connections=1000, pool_maxsize=1000)
|
||||
# 任何使用该session会话的 HTTP 请求,只要其 URL 是以给定的前缀开头,该传输适配器就会被使用到。
|
||||
self.__class__.session.mount("http", http_adapter)
|
||||
|
||||
return self.__class__.session
|
||||
|
||||
def download(self, request) -> Response:
|
||||
response = self._session.request(
|
||||
request.method, request.url, **request.requests_kwargs
|
||||
)
|
||||
response = Response(response)
|
||||
return response
|
||||
```
|
||||
|
||||
2. 在settings中指定下载器
|
||||
|
||||
```
|
||||
SESSION_DOWNLOADER = "downloader.my_downloader.RequestsSessionDownloader"
|
||||
```
|
||||
|
||||
注意,这里要配置 `SESSION_DOWNLOADER`
|
||||
|
||||
## 自定义浏览器渲染下载器
|
||||
|
||||
1. 编写下载器 `xxx-spider/downloader/my_downloader.py `
|
||||
|
||||
**若浏览器框架本身不支持多线程,但想在多线程中使用,如playwright使用,参考如下:**
|
||||
|
||||
```
|
||||
import feapder.setting as setting
|
||||
import feapder.utils.tools as tools
|
||||
from feapder.network.downloader.base import RenderDownloader
|
||||
from feapder.network.response import Response
|
||||
from feapder.utils.webdriver import WebDriverPool, PlaywrightDriver
|
||||
|
||||
|
||||
class MyDownloader(RenderDownloader):
|
||||
webdriver_pool: WebDriverPool = None
|
||||
|
||||
@property
|
||||
def _webdriver_pool(self):
|
||||
if not self.__class__.webdriver_pool:
|
||||
self.__class__.webdriver_pool = WebDriverPool(
|
||||
**setting.PLAYWRIGHT, driver_cls=PlaywrightDriver, thread_safe=True
|
||||
)
|
||||
|
||||
return self.__class__.webdriver_pool
|
||||
|
||||
def download(self, request) -> Response:
|
||||
# 代理优先级 自定义 > 配置文件 > 随机
|
||||
if request.custom_proxies:
|
||||
proxy = request.get_proxy()
|
||||
elif setting.PLAYWRIGHT.get("proxy"):
|
||||
proxy = setting.PLAYWRIGHT.get("proxy")
|
||||
else:
|
||||
proxy = request.get_proxy()
|
||||
|
||||
# user_agent优先级 自定义 > 配置文件 > 随机
|
||||
if request.custom_ua:
|
||||
user_agent = request.get_user_agent()
|
||||
elif setting.PLAYWRIGHT.get("user_agent"):
|
||||
user_agent = setting.PLAYWRIGHT.get("user_agent")
|
||||
else:
|
||||
user_agent = request.get_user_agent()
|
||||
|
||||
cookies = request.get_cookies()
|
||||
url = request.url
|
||||
render_time = request.render_time or setting.PLAYWRIGHT.get("render_time")
|
||||
wait_until = setting.PLAYWRIGHT.get("wait_until") or "domcontentloaded"
|
||||
if request.get_params():
|
||||
url = tools.joint_url(url, request.get_params())
|
||||
|
||||
driver: PlaywrightDriver = self._webdriver_pool.get(
|
||||
user_agent=user_agent, proxy=proxy
|
||||
)
|
||||
try:
|
||||
if cookies:
|
||||
driver.url = url
|
||||
driver.cookies = cookies
|
||||
driver.page.goto(url, wait_until=wait_until)
|
||||
|
||||
if render_time:
|
||||
tools.delay_time(render_time)
|
||||
|
||||
html = driver.page.content()
|
||||
response = Response.from_dict(
|
||||
{
|
||||
"url": driver.page.url,
|
||||
"cookies": driver.cookies,
|
||||
"_content": html.encode(),
|
||||
"status_code": 200,
|
||||
"elapsed": 666,
|
||||
"headers": {
|
||||
"User-Agent": driver.user_agent,
|
||||
"Cookie": tools.cookies2str(driver.cookies),
|
||||
},
|
||||
}
|
||||
)
|
||||
|
||||
response.driver = driver
|
||||
response.browser = driver
|
||||
return response
|
||||
except Exception as e:
|
||||
self._webdriver_pool.remove(driver)
|
||||
raise e
|
||||
|
||||
def close(self, driver):
|
||||
if driver:
|
||||
self._webdriver_pool.remove(driver)
|
||||
|
||||
def put_back(self, driver):
|
||||
"""
|
||||
释放浏览器对象
|
||||
"""
|
||||
self._webdriver_pool.put(driver)
|
||||
|
||||
def close_all(self):
|
||||
"""
|
||||
关闭所有浏览器
|
||||
"""
|
||||
# 不支持
|
||||
# self._webdriver_pool.close()
|
||||
pass
|
||||
```
|
||||
|
||||
这里使用了WebDriverPool,参数`thread_safe=True`,即要保证使用时的线程安全,确保同个浏览器对象只能被同一个线程调用
|
||||
|
||||
**若浏览器框架本身支持多线程,如selenium,则参考如下**
|
||||
|
||||
```
|
||||
import feapder.setting as setting
|
||||
import feapder.utils.tools as tools
|
||||
from feapder.network.downloader.base import RenderDownloader
|
||||
from feapder.network.response import Response
|
||||
from feapder.utils.webdriver import WebDriverPool, SeleniumDriver
|
||||
|
||||
|
||||
class MyDownloader(RenderDownloader):
|
||||
webdriver_pool: WebDriverPool = None
|
||||
|
||||
@property
|
||||
def _webdriver_pool(self):
|
||||
if not self.__class__.webdriver_pool:
|
||||
self.__class__.webdriver_pool = WebDriverPool(
|
||||
**setting.WEBDRIVER, driver=SeleniumDriver
|
||||
)
|
||||
|
||||
return self.__class__.webdriver_pool
|
||||
|
||||
def download(self, request) -> Response:
|
||||
# 代理优先级 自定义 > 配置文件 > 随机
|
||||
if request.custom_proxies:
|
||||
proxy = request.get_proxy()
|
||||
elif setting.WEBDRIVER.get("proxy"):
|
||||
proxy = setting.WEBDRIVER.get("proxy")
|
||||
else:
|
||||
proxy = request.get_proxy()
|
||||
|
||||
# user_agent优先级 自定义 > 配置文件 > 随机
|
||||
if request.custom_ua:
|
||||
user_agent = request.get_user_agent()
|
||||
elif setting.WEBDRIVER.get("user_agent"):
|
||||
user_agent = setting.WEBDRIVER.get("user_agent")
|
||||
else:
|
||||
user_agent = request.get_user_agent()
|
||||
|
||||
cookies = request.get_cookies()
|
||||
url = request.url
|
||||
render_time = request.render_time or setting.WEBDRIVER.get("render_time")
|
||||
if request.get_params():
|
||||
url = tools.joint_url(url, request.get_params())
|
||||
|
||||
browser: SeleniumDriver = self._webdriver_pool.get(
|
||||
user_agent=user_agent, proxy=proxy
|
||||
)
|
||||
try:
|
||||
browser.get(url)
|
||||
if cookies:
|
||||
browser.cookies = cookies
|
||||
# 刷新使cookie生效
|
||||
browser.get(url)
|
||||
|
||||
if render_time:
|
||||
tools.delay_time(render_time)
|
||||
|
||||
html = browser.page_source
|
||||
response = Response.from_dict(
|
||||
{
|
||||
"url": browser.current_url,
|
||||
"cookies": browser.cookies,
|
||||
"_content": html.encode(),
|
||||
"status_code": 200,
|
||||
"elapsed": 666,
|
||||
"headers": {
|
||||
"User-Agent": browser.user_agent,
|
||||
"Cookie": tools.cookies2str(browser.cookies),
|
||||
},
|
||||
}
|
||||
)
|
||||
|
||||
response.driver = browser
|
||||
response.browser = browser
|
||||
return response
|
||||
except Exception as e:
|
||||
self._webdriver_pool.remove(browser)
|
||||
raise e
|
||||
|
||||
def close(self, driver):
|
||||
if driver:
|
||||
self._webdriver_pool.remove(driver)
|
||||
|
||||
def put_back(self, driver):
|
||||
"""
|
||||
释放浏览器对象
|
||||
"""
|
||||
self._webdriver_pool.put(driver)
|
||||
|
||||
def close_all(self):
|
||||
"""
|
||||
关闭所有浏览器
|
||||
"""
|
||||
self._webdriver_pool.close()
|
||||
```
|
||||
|
||||
2. 在settings中指定下载器
|
||||
|
||||
```
|
||||
RENDER_DOWNLOADER = "downloader.my_downloader.MyDownloader"
|
||||
```
|
||||
|
||||
注,这里要写`RENDER_DOWNLOADER`
|
||||
@@ -0,0 +1,136 @@
|
||||
# Dedup
|
||||
|
||||
Dedup是feapder大数据去重模块,不同于BloomFilter,去重受槽位数量影响,Dedup使用了弹性的去重机制,可容纳海量的数据去重。
|
||||
|
||||
|
||||
## 去重方式
|
||||
|
||||
### 临时去重
|
||||
|
||||
> 基于redis,支持批量,去重有时效性。去重一万条数据约0.26秒,一亿条数据占用内存约1.43G
|
||||
|
||||
```python
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
data = {"xxx": 123, "xxxx": "xxxx"}
|
||||
datas = ["xxx", "bbb"]
|
||||
|
||||
def test_ExpireFilter():
|
||||
dedup = Dedup(
|
||||
Dedup.ExpireFilter, expire_time=10, redis_url="redis://@localhost:6379/0"
|
||||
)
|
||||
|
||||
# 逐条去重
|
||||
assert dedup.add(data) == 1
|
||||
assert dedup.get(data) == 1
|
||||
|
||||
# 批量去重
|
||||
assert dedup.add(datas) == [1, 1]
|
||||
assert dedup.get(datas) == [1, 1]
|
||||
```
|
||||
|
||||
|
||||
### 内存去重
|
||||
|
||||
> 基于内存,支持批量。去重一万条数据约0.5秒,一亿条数据占用内存约285MB
|
||||
|
||||
```python
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
data = {"xxx": 123, "xxxx": "xxxx"}
|
||||
datas = ["xxx", "bbb"]
|
||||
|
||||
def test_MemoryFilter():
|
||||
dedup = Dedup(Dedup.MemoryFilter) # 表名为test 历史数据3秒有效期
|
||||
|
||||
# 逐条去重
|
||||
assert dedup.add(data) == 1
|
||||
assert dedup.get(data) == 1
|
||||
|
||||
# 批量去重
|
||||
assert dedup.add(datas) == [1, 1]
|
||||
assert dedup.get(datas) == [1, 1]
|
||||
```
|
||||
|
||||
### 永久去重
|
||||
|
||||
> 基于redis,支持批量,永久去重。 去重一万条数据约3.5秒,一亿条数据占用内存约285MB
|
||||
|
||||
```python
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
def test_BloomFilter():
|
||||
dedup = Dedup(Dedup.BloomFilter, redis_url="redis://@localhost:6379/0")
|
||||
|
||||
# 逐条去重
|
||||
assert dedup.add(data) == 1
|
||||
assert dedup.get(data) == 1
|
||||
|
||||
# 批量去重
|
||||
assert dedup.add(datas) == [1, 1]
|
||||
assert dedup.get(datas) == [1, 1]
|
||||
```
|
||||
|
||||
## 过滤数据
|
||||
|
||||
Dedup可以通过如下方法,过滤掉已存在的数据
|
||||
|
||||
|
||||
```python
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
def test_filter():
|
||||
dedup = Dedup(Dedup.BloomFilter, redis_url="redis://@localhost:6379/0")
|
||||
|
||||
# 制造已存在数据
|
||||
datas = ["xxx", "bbb"]
|
||||
dedup.add(datas)
|
||||
|
||||
# 过滤掉已存在数据 "xxx", "bbb"
|
||||
datas = ["xxx", "bbb", "ccc"]
|
||||
dedup.filter_exist_data(datas)
|
||||
assert datas == ["ccc"]
|
||||
```
|
||||
|
||||
## Dedup参数
|
||||
|
||||
- **filter_type**:去重类型,支持BloomFilter、MemoryFilter、ExpireFilter三种
|
||||
- **redis_url**不是必须传递的,若项目中存在setting.py文件,且已配置redis连接方式,则可以不传递redis_url
|
||||
|
||||

|
||||
|
||||
```
|
||||
import feapder
|
||||
from feapder.dedup import Dedup
|
||||
|
||||
class TestSpider(feapder.Spider):
|
||||
def __init__(self, *args, **kwargs):
|
||||
self.dedup = Dedup() # 默认是永久去重
|
||||
```
|
||||
|
||||
- **name**: 过滤器名称 该名称会默认以dedup作为前缀 `dedup:expire_set:[name]`或`dedup:bloomfilter:[name]`。 默认ExpireFilter name=过期时间,BloomFilter name=`dedup:bloomfilter:bloomfilter`
|
||||
|
||||

|
||||
|
||||
若对不同数据源去重,可通过name参数来指定不同去重库
|
||||
|
||||
- **absolute_name**:过滤器绝对名称 不会加dedup前缀
|
||||
- **expire_time**:ExpireFilter的过期时间 单位为秒,其他两种过滤器不用指定
|
||||
- **error_rate**:BloomFilter/MemoryFilter的误判率 默认为0.00001
|
||||
- **to_md5**:去重前是否将数据转为MD5,默认是
|
||||
|
||||
## 爬虫中使用
|
||||
|
||||
框架支持对请求和入库的数据进行去重,仅需要在[配置文件](source_code/配置文件)中进行配置即可
|
||||
|
||||
```python
|
||||
ITEM_FILTER_ENABLE = False # item 去重
|
||||
REQUEST_FILTER_ENABLE = False # request 去重
|
||||
```
|
||||
|
||||
或者可以直接导入此去重模块使用
|
||||
|
||||
```python
|
||||
from feapder.dedup import Dedup
|
||||
```
|
||||
|
||||
@@ -0,0 +1,40 @@
|
||||
# 日志配置及使用
|
||||
|
||||
## 日志配置
|
||||
|
||||
见配置文件,相关配置如下:
|
||||
|
||||
```python
|
||||
LOG_NAME = os.path.basename(os.getcwd())
|
||||
LOG_PATH = "log/%s.log" % LOG_NAME # log存储路径
|
||||
LOG_LEVEL = "DEBUG"
|
||||
LOG_COLOR = True # 是否带有颜色
|
||||
LOG_IS_WRITE_TO_CONSOLE = True # 是否打印到控制台
|
||||
LOG_IS_WRITE_TO_FILE = False # 是否写文件
|
||||
LOG_MODE = "w" # 写文件的模式
|
||||
LOG_MAX_BYTES = 10 * 1024 * 1024 # 每个日志文件的最大字节数
|
||||
LOG_BACKUP_COUNT = 20 # 日志文件保留数量
|
||||
LOG_ENCODING = "utf8" # 日志文件编码
|
||||
OTHERS_LOG_LEVAL = "ERROR" # 第三方库的log等级
|
||||
```
|
||||
|
||||
框架屏蔽了requests、selenium等一些第三方库的日志,OTHERS_LOG_LEVAL是用来控制这些第三库日志等级的。
|
||||
|
||||
## 使用日志工具
|
||||
|
||||
|
||||
```python
|
||||
from feapder.utils.log import log
|
||||
|
||||
log.debug("xxx")
|
||||
log.info("xxx")
|
||||
log.warning("xxx")
|
||||
log.error("xxx")
|
||||
log.critical("xxx")
|
||||
```
|
||||
|
||||
默认是带有颜色的日志:
|
||||
|
||||

|
||||
|
||||
日志等级:CRITICAL > ERROR > WARNING > INFO > DEBUG
|
||||
@@ -0,0 +1,91 @@
|
||||
# Pipeline
|
||||
|
||||
Pipeline是数据入库时流经的管道,用户可自定义,以便对接其他数据库。
|
||||
|
||||
框架已内置mysql、mongo、csv管道,其他管道作为扩展方式提供,可从[feapder_pipelines](https://github.com/Boris-code/feapder_pipelines)项目中按需安装
|
||||
|
||||
项目地址:https://github.com/Boris-code/feapder_pipelines
|
||||
|
||||
## 选择内置的pipeline
|
||||
|
||||
在配置文件 `setting.py` 中的 `ITEM_PIPELINES` 中启用:
|
||||
|
||||
```python
|
||||
ITEM_PIPELINES = [
|
||||
"feapder.pipelines.mysql_pipeline.MysqlPipeline",
|
||||
# "feapder.pipelines.mongo_pipeline.MongoPipeline",
|
||||
# "feapder.pipelines.csv_pipeline.CsvPipeline",
|
||||
# "feapder.pipelines.console_pipeline.ConsolePipeline",
|
||||
]
|
||||
```
|
||||
|
||||
然后 爬虫中`yield`的`item`会流经选择的pipeline自动存储
|
||||
|
||||
## 自定义pipeline
|
||||
|
||||
注:item会被聚合成多条一起流经pipeline,方便批量入库
|
||||
|
||||
### 1. 编写pipeline
|
||||
|
||||
```python
|
||||
from feapder.pipelines import BasePipeline
|
||||
from typing import Dict, List, Tuple
|
||||
|
||||
|
||||
class Pipeline(BasePipeline):
|
||||
"""
|
||||
pipeline 是单线程的,批量保存数据的操作,不建议在这里写网络请求代码,如下载图片等
|
||||
"""
|
||||
|
||||
def save_items(self, table, items: List[Dict]) -> bool:
|
||||
"""
|
||||
保存数据
|
||||
Args:
|
||||
table: 表名
|
||||
items: 数据,[{},{},...]
|
||||
|
||||
Returns: 是否保存成功 True / False
|
||||
若False,不会将本批数据入到去重库,以便再次入库
|
||||
|
||||
"""
|
||||
|
||||
print("自定义pipeline, 保存数据 >>>>", table, items)
|
||||
|
||||
return True
|
||||
|
||||
def update_items(self, table, items: List[Dict], update_keys=Tuple) -> bool:
|
||||
"""
|
||||
更新数据, 与UpdateItem配合使用,若爬虫中没使用UpdateItem,则可不实现此接口
|
||||
Args:
|
||||
table: 表名
|
||||
items: 数据,[{},{},...]
|
||||
update_keys: 更新的字段, 如 ("title", "publish_time")
|
||||
|
||||
Returns: 是否更新成功 True / False
|
||||
若False,不会将本批数据入到去重库,以便再次入库
|
||||
|
||||
"""
|
||||
|
||||
print("自定义pipeline, 更新数据 >>>>", table, items, update_keys)
|
||||
|
||||
return True
|
||||
```
|
||||
|
||||
`Pipeline`需继承`BasePipeline`,类名和存放位置随意,需要实现`save_items`接口。一定要有返回值,返回`False`表示数据没保存成功,会触发重试逻辑
|
||||
|
||||
`update_items`接口与`UpdateItem`配合使用,更新数据时使用,若爬虫中没使用UpdateItem,则可不实现此接口
|
||||
|
||||
### 2. 编写配置文件
|
||||
|
||||
```python
|
||||
# 数据入库的pipeline,支持多个
|
||||
ITEM_PIPELINES = [
|
||||
"pipeline.Pipeline"
|
||||
]
|
||||
```
|
||||
|
||||
将编写好的pipeline配置进来,值为类的模块路径,需要指定到具体的类名
|
||||
|
||||
## 示例
|
||||
|
||||
地址:https://github.com/Boris-code/feapder/tree/master/tests/test-pipeline
|
||||
@@ -0,0 +1,104 @@
|
||||
# 代理使用说明
|
||||
|
||||
代理使用有三种方式
|
||||
1. 使用框架内置代理池
|
||||
2. 自定义代理池
|
||||
3. 请求中直接指定
|
||||
|
||||
## 方式1. 使用框架内置代理池
|
||||
|
||||
### 配置代理
|
||||
|
||||
在配置文件中配置代理提取接口
|
||||
|
||||
```python
|
||||
# 设置代理
|
||||
PROXY_EXTRACT_API = None # 代理提取API ,返回的代理分割符为\r\n
|
||||
PROXY_ENABLE = True
|
||||
PROXY_MAX_FAILED_TIMES = 5 # 代理最大失败次数,超过则不使用,自动删除
|
||||
```
|
||||
|
||||
要求API返回的代理格式为使用 /r/n 分隔:
|
||||
|
||||
```
|
||||
ip:port
|
||||
ip:port
|
||||
ip:port
|
||||
```
|
||||
|
||||
这样feapder在请求时会自动随机使用上面的代理请求了
|
||||
|
||||
## 管理代理
|
||||
|
||||
1. 删除代理(默认是请求异常连续5次,再删除代理)
|
||||
|
||||
例如在发生异常时删除代理
|
||||
|
||||
```python
|
||||
import feapder
|
||||
class TestProxy(feapder.AirSpider):
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com")
|
||||
|
||||
def parse(self, request, response):
|
||||
print(response)
|
||||
|
||||
def exception_request(self, request, response):
|
||||
request.del_proxy()
|
||||
|
||||
```
|
||||
|
||||
## 方式2. 自定义代理池
|
||||
|
||||
1. 编写代理池:例如在你的项目下创建个my_proxypool.py,实现下面的函数
|
||||
|
||||
```python
|
||||
from feapder.network.proxy_pool import BaseProxyPool
|
||||
|
||||
class MyProxyPool(BaseProxyPool):
|
||||
def get_proxy(self):
|
||||
"""
|
||||
获取代理
|
||||
Returns:
|
||||
{"http": "xxx", "https": "xxx"}
|
||||
"""
|
||||
pass
|
||||
|
||||
def del_proxy(self, proxy):
|
||||
"""
|
||||
@summary: 删除代理
|
||||
---------
|
||||
@param proxy: xxx
|
||||
"""
|
||||
pass
|
||||
```
|
||||
|
||||
3. 修改setting的代理配置
|
||||
|
||||
```
|
||||
PROXY_POOL = "my_proxypool.MyProxyPool" # 代理池
|
||||
```
|
||||
|
||||
将编写好的代理池配置进来,值为类的模块路径,需要指定到具体的类名
|
||||
|
||||
|
||||
|
||||
## 方式3. 不使用代理池,直接给请求指定代理
|
||||
|
||||
直接给request.proxies赋值即可,例如在下载中间件里使用
|
||||
|
||||
```python
|
||||
import feapder
|
||||
|
||||
class TestProxy(feapder.AirSpider):
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com")
|
||||
|
||||
def download_midware(self, request):
|
||||
# 这里使用代理使用即可
|
||||
request.proxies = {"https": "https://ip:port", "http": "http://ip:port"}
|
||||
return request
|
||||
|
||||
def parse(self, request, response):
|
||||
print(response)
|
||||
```
|
||||
@@ -0,0 +1,17 @@
|
||||
|
||||
# tools
|
||||
|
||||
`feapder.utils.tools`里封装了爬虫中常用的函数,目前共计**129**个,可通过阅读源码了解使用
|
||||
|
||||
## 举例
|
||||
|
||||
### 时间格式化
|
||||
|
||||
```python
|
||||
from feapder.utils import tools
|
||||
|
||||
time = "昨天"
|
||||
|
||||
date = tools.format_time(time)
|
||||
assert date == "2021-03-15 00:00:00"
|
||||
```
|
||||
@@ -0,0 +1,121 @@
|
||||
# 报警及监控
|
||||
|
||||
支持钉钉、飞书、企业微信、邮件报警
|
||||
|
||||
## 钉钉报警
|
||||
|
||||
条件:需要有钉钉群,需要获取钉钉机器人的Webhook地址
|
||||
|
||||
获取方式参考官方文档:https://developers.dingtalk.com/document/app/custom-robot-access
|
||||
|
||||
安全设置选择自定义关键词,填入**feapder**
|
||||
|
||||
|
||||
|
||||
或使用加签方式,然后在setting中设置密钥
|
||||
|
||||
相关配置:
|
||||
|
||||
```python
|
||||
# 钉钉报警
|
||||
DINGDING_WARNING_URL = "" # 钉钉机器人api
|
||||
DINGDING_WARNING_PHONE = "" # 报警人 支持列表,可指定多个
|
||||
DINGDING_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
DINGDING_WARNING_SECRET = None # 加签密钥
|
||||
```
|
||||
|
||||
## 企业微信报警
|
||||
|
||||
条件:需要企业微信群,并获取企业微信机器人的Webhook地址
|
||||
|
||||
获取方式:https://weibanzhushou.com/blog/330
|
||||
|
||||
报警简介:
|
||||
|
||||
- 仅支持文本模式
|
||||
- 当用户手机号码为空字符串或`WECHAT_WARNING_ALL`为`True`时将会`@全体成员`
|
||||
|
||||
|
||||
相关设置:
|
||||
|
||||
```python
|
||||
# 企业微信报警
|
||||
WECHAT_WARNING_URL = "" # 企业微信机器人api
|
||||
WECHAT_WARNING_PHONE = "" # 报警人 将会在群内@此人, 支持列表,可指定多人
|
||||
WECHAT_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
```
|
||||
|
||||
## 飞书报警
|
||||
|
||||
可参考文档设置机器人:https://open.feishu.cn/document/ukTMukTMukTM/ucTM5YjL3ETO24yNxkjN#e1cdee9f
|
||||
|
||||
然后在feapder的setting文件中修改如下配置
|
||||
|
||||
```
|
||||
FEISHU_WARNING_URL = "" # 飞书机器人api
|
||||
FEISHU_WARNING_USER = None # 报警人 {"open_id":"ou_xxxxx", "name":"xxxx"} 或 [{"open_id":"ou_xxxxx", "name":"xxxx"}]
|
||||
FEISHU_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
```
|
||||
|
||||
## 邮件报警
|
||||
|
||||
相关配置:
|
||||
|
||||
```
|
||||
# 邮件报警
|
||||
EMAIL_SENDER = "" # 发件人
|
||||
EMAIL_PASSWORD = "" # 授权码
|
||||
EMAIL_RECEIVER = "" # 收件人 支持列表,可指定多个
|
||||
```
|
||||
|
||||
邮件报警目前支持163邮箱作为发送者,`EMAIL_SENDER`为邮箱账号,如`feapder@163.com`, `EMAIL_PASSWORD`为授权码,不是登录密码,获取授权码的流程如下:
|
||||
|
||||
1. 设置 -> POP3/SMTP/IMAP
|
||||
|
||||

|
||||
|
||||
2. 开启SMTP服务
|
||||
|
||||

|
||||
|
||||
开启后,会弹出授权码,该授权码即为EMAIL_PASSWORD
|
||||
|
||||
3. 设置反垃圾规则为高级
|
||||
|
||||

|
||||
|
||||
4. 将本邮箱账号添加到白名单中
|
||||
|
||||
## Qmsg酱报警
|
||||
|
||||
Qmsg酱是一个QQ消息推送机器人,用来通知自己消息的免费服务。
|
||||
|
||||
可以参考文档:https://qmsg.zendee.cn/docs/api/
|
||||
|
||||
```python
|
||||
# QMSG报警
|
||||
QMSG_WARNING_URL = "" # qmsg机器人api
|
||||
QMSG_WARNING_QQ = "" # 指定要接收消息的QQ号或者QQ群。多个以英文逗号分割,例如:12345,12346,支持列表,可指定多人
|
||||
QMSG_WARNING_BOT = "" # 机器人的QQ号
|
||||
```
|
||||
|
||||
|
||||
## 报警间隔及报警级别
|
||||
|
||||
框架会对相同的报警进行过滤,防止刷屏,默认的报警时间间隔为1小时,可通过以下配置修改:
|
||||
|
||||
```python
|
||||
WARNING_INTERVAL = 3600 # 相同报警的报警时间间隔,防止刷屏
|
||||
WARNING_LEVEL = "DEBUG" # 报警级别, DEBUG / ERROR
|
||||
```
|
||||
|
||||
DEBUG级别的报警包含一些运行信息,ERROR级别的报警都是有问题的报警,需要及时处理
|
||||
|
||||
|
||||
## 可视化监控
|
||||
|
||||
支持对爬虫运行情况进行监控,除了数据监控和请求监控外,用户还可自定义监控内容,详情参考[自定义监控](source_code/监控打点?id=自定义监控)
|
||||
|
||||
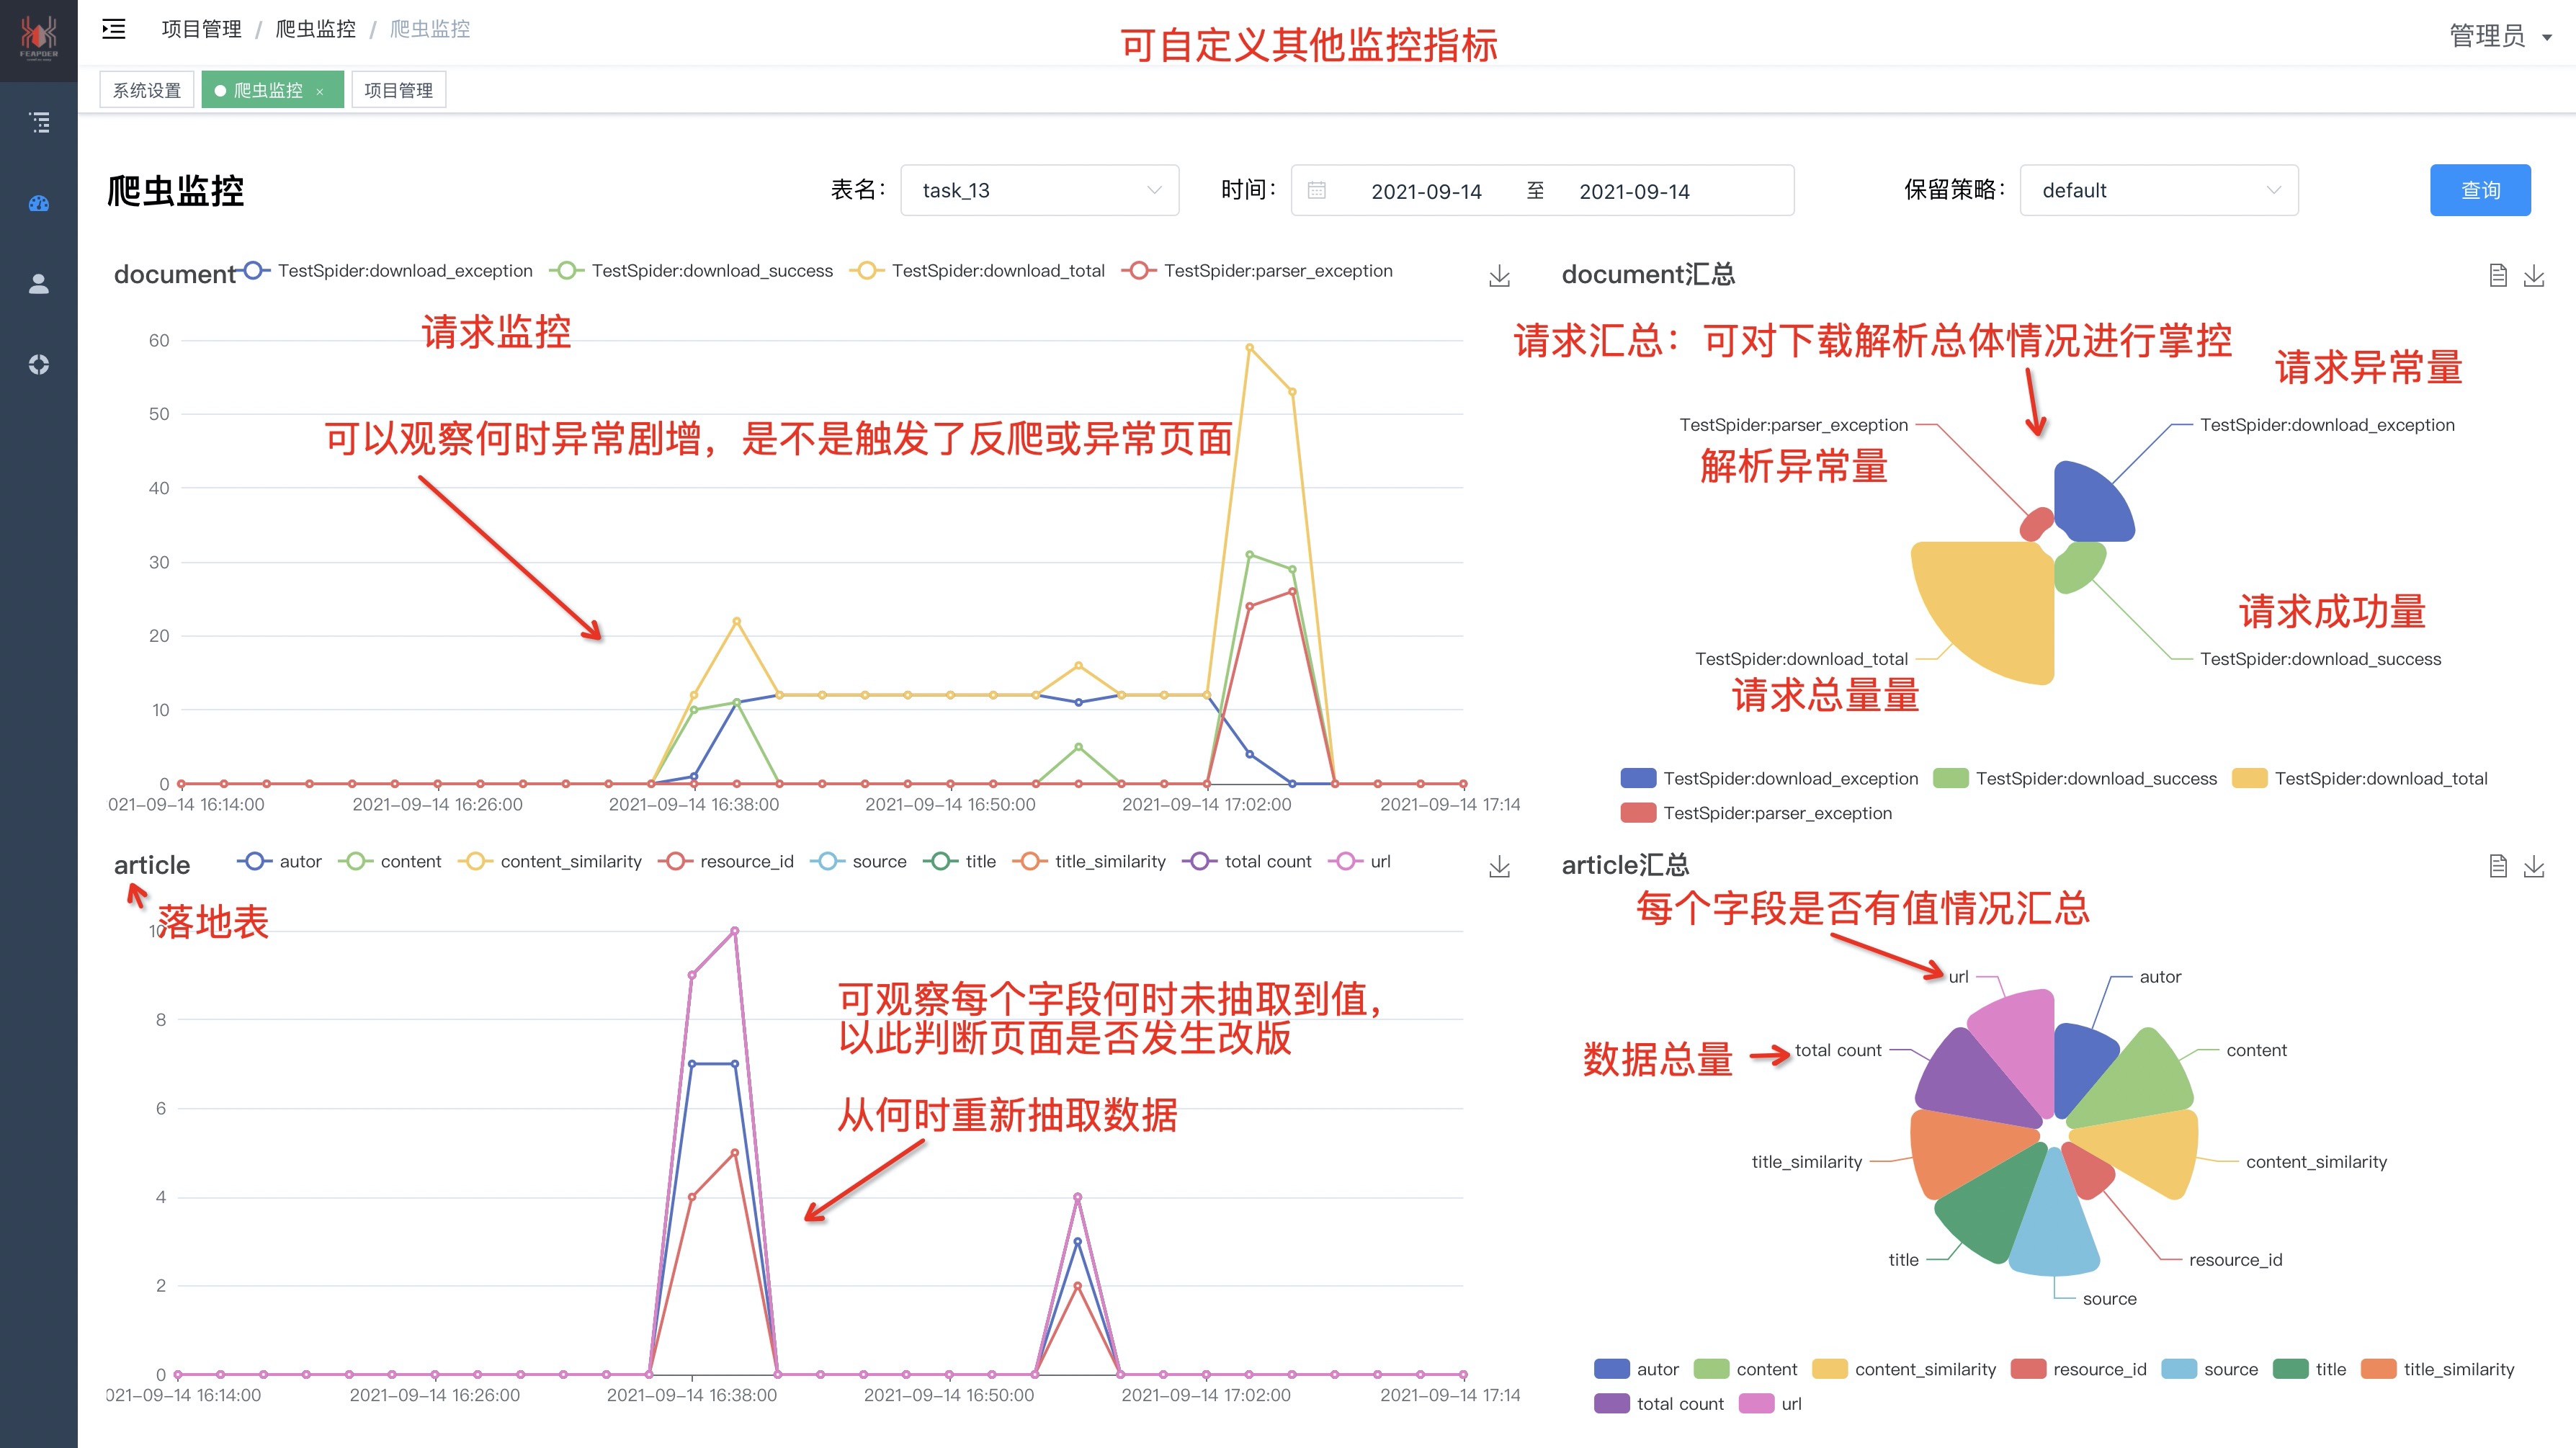
|
||||
|
||||
需 feapder>=1.6.6, 需配合feaplat爬虫管理平台
|
||||
@@ -0,0 +1,258 @@
|
||||
# 浏览器渲染-Playwright
|
||||
|
||||
采集动态页面时(Ajax渲染的页面),常用的有两种方案。一种是找接口拼参数,这种方式比较复杂但效率高,需要一定的爬虫功底;另外一种是采用浏览器渲染的方式,直接获取源码,简单方便
|
||||
|
||||
框架支持playwright渲染下载,每个线程持有一个playwright实例
|
||||
|
||||
|
||||
## 使用方式:
|
||||
|
||||
1. 修改配置文件的渲染下载器:
|
||||
|
||||
```
|
||||
RENDER_DOWNLOADER="feapder.network.downloader.PlaywrightDownloader"
|
||||
```
|
||||
2. 使用
|
||||
|
||||
```python
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://news.qq.com/", render=True)
|
||||
```
|
||||
|
||||
在返回的Request中传递`render=True`即可
|
||||
|
||||
框架支持`chromium`、`firefox`、`webkit` 三种浏览器渲染,可通过[配置文件](source_code/配置文件)进行配置。相关配置如下:
|
||||
|
||||
```python
|
||||
PLAYWRIGHT = dict(
|
||||
user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
headless=False, # 是否为无头浏览器
|
||||
driver_type="chromium", # chromium、firefox、webkit
|
||||
timeout=30, # 请求超时时间
|
||||
window_size=(1024, 800), # 窗口大小
|
||||
executable_path=None, # 浏览器路径,默认为默认路径
|
||||
download_path=None, # 下载文件的路径
|
||||
render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
wait_until="networkidle", # 等待页面加载完成的事件,可选值:"commit", "domcontentloaded", "load", "networkidle"
|
||||
use_stealth_js=False, # 使用stealth.min.js隐藏浏览器特征
|
||||
page_on_event_callback=None, # page.on() 事件的回调 如 page_on_event_callback={"dialog": lambda dialog: dialog.accept()}
|
||||
storage_state_path=None, # 保存浏览器状态的路径
|
||||
url_regexes=None, # 拦截接口,支持正则,数组类型
|
||||
save_all=False, # 是否保存所有拦截的接口, 配合url_regexes使用,为False时只保存最后一次拦截的接口
|
||||
)
|
||||
```
|
||||
|
||||
- `feapder.Request` 也支持`render_time`参数, 优先级大于配置文件中的`render_time`
|
||||
|
||||
- 代理使用优先级:`feapder.Request`指定的代理 > 配置文件中的`PROXY_EXTRACT_API` > webdriver配置文件中的`proxy`
|
||||
|
||||
- user_agent使用优先级:`feapder.Request`指定的header里的`User-Agent` > 框架随机的`User-Agent` > webdriver配置文件中的`user_agent`
|
||||
|
||||
## 设置User-Agent
|
||||
|
||||
> 每次生成一个新的浏览器实例时生效
|
||||
|
||||
### 方式1:
|
||||
|
||||
通过配置文件的 `user_agent` 参数设置
|
||||
|
||||
### 方式2:
|
||||
|
||||
通过 `feapder.Request`携带,优先级大于配置文件, 如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.headers = {
|
||||
"User-Agent": "xxxxxxxx"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
## 设置代理
|
||||
|
||||
> 每次生成一个新的浏览器实例时生效
|
||||
|
||||
### 方式1:
|
||||
|
||||
通过配置文件的 `proxy` 参数设置
|
||||
|
||||
### 方式2:
|
||||
|
||||
通过 `feapder.Request`携带,优先级大于配置文件, 如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.proxies = {
|
||||
"https": "https://xxx.xxx.xxx.xxx:xxxx"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
## 设置Cookie
|
||||
|
||||
通过 `feapder.Request`携带,如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.headers = {
|
||||
"Cookie": "key=value; key2=value2"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
或者
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.cookies = {
|
||||
"key": "value",
|
||||
"key2": "value2",
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
或者
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.cookies = [
|
||||
{
|
||||
"domain": "xxx",
|
||||
"name": "xxx",
|
||||
"value": "xxx",
|
||||
"expirationDate": "xxx"
|
||||
},
|
||||
]
|
||||
return request
|
||||
```
|
||||
|
||||
## 拦截数据示例
|
||||
|
||||
> 注意:主函数使用run方法运行,不能使用start
|
||||
|
||||
```python
|
||||
from playwright.sync_api import Response
|
||||
from feapder.utils.webdriver import (
|
||||
PlaywrightDriver,
|
||||
InterceptResponse,
|
||||
InterceptRequest,
|
||||
)
|
||||
|
||||
import feapder
|
||||
|
||||
|
||||
def on_response(response: Response):
|
||||
print(response.url)
|
||||
|
||||
|
||||
class TestPlaywright(feapder.AirSpider):
|
||||
__custom_setting__ = dict(
|
||||
RENDER_DOWNLOADER="feapder.network.downloader.PlaywrightDownloader",
|
||||
PLAYWRIGHT=dict(
|
||||
user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
headless=False, # 是否为无头浏览器
|
||||
driver_type="chromium", # chromium、firefox、webkit
|
||||
timeout=30, # 请求超时时间
|
||||
window_size=(1024, 800), # 窗口大小
|
||||
executable_path=None, # 浏览器路径,默认为默认路径
|
||||
download_path=None, # 下载文件的路径
|
||||
render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
wait_until="networkidle", # 等待页面加载完成的事件,可选值:"commit", "domcontentloaded", "load", "networkidle"
|
||||
use_stealth_js=False, # 使用stealth.min.js隐藏浏览器特征
|
||||
# page_on_event_callback=dict(response=on_response), # 监听response事件
|
||||
# page.on() 事件的回调 如 page_on_event_callback={"dialog": lambda dialog: dialog.accept()}
|
||||
storage_state_path=None, # 保存浏览器状态的路径
|
||||
url_regexes=["wallpaper/list"], # 拦截接口,支持正则,数组类型
|
||||
save_all=True, # 是否保存所有拦截的接口
|
||||
),
|
||||
)
|
||||
|
||||
def start_requests(self):
|
||||
yield feapder.Request(
|
||||
"http://www.soutushenqi.com/image/search/?searchWord=%E6%A0%91%E5%8F%B6",
|
||||
render=True,
|
||||
)
|
||||
|
||||
def parse(self, reqeust, response):
|
||||
driver: PlaywrightDriver = response.driver
|
||||
|
||||
intercept_response: InterceptResponse = driver.get_response("wallpaper/list")
|
||||
intercept_request: InterceptRequest = intercept_response.request
|
||||
|
||||
req_url = intercept_request.url
|
||||
req_header = intercept_request.headers
|
||||
req_data = intercept_request.data
|
||||
print("请求url", req_url)
|
||||
print("请求header", req_header)
|
||||
print("请求data", req_data)
|
||||
|
||||
data = driver.get_json("wallpaper/list")
|
||||
print("接口返回的数据", data)
|
||||
|
||||
print("------ 测试save_all=True ------- ")
|
||||
|
||||
# 测试save_all=True
|
||||
all_intercept_response: list = driver.get_all_response("wallpaper/list")
|
||||
for intercept_response in all_intercept_response:
|
||||
intercept_request: InterceptRequest = intercept_response.request
|
||||
req_url = intercept_request.url
|
||||
req_header = intercept_request.headers
|
||||
req_data = intercept_request.data
|
||||
print("请求url", req_url)
|
||||
print("请求header", req_header)
|
||||
print("请求data", req_data)
|
||||
|
||||
all_intercept_json = driver.get_all_json("wallpaper/list")
|
||||
for intercept_json in all_intercept_json:
|
||||
print("接口返回的数据", intercept_json)
|
||||
|
||||
# 千万别忘了
|
||||
driver.clear_cache()
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestPlaywright(thread_count=1).run()
|
||||
```
|
||||
可通过配置的`page_on_event_callback`参数自定义事件的回调,如设置`on_response`的事件回调,亦可直接使用`url_regexes`设置拦截的接口
|
||||
|
||||
## 操作浏览器对象示例
|
||||
|
||||
> 注意:主函数使用run方法运行,不能使用start
|
||||
|
||||
```python
|
||||
import time
|
||||
|
||||
from playwright.sync_api import Page
|
||||
|
||||
import feapder
|
||||
from feapder.utils.webdriver import PlaywrightDriver
|
||||
|
||||
|
||||
class TestPlaywright(feapder.AirSpider):
|
||||
__custom_setting__ = dict(
|
||||
RENDER_DOWNLOADER="feapder.network.downloader.PlaywrightDownloader",
|
||||
)
|
||||
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com", render=True)
|
||||
|
||||
def parse(self, reqeust, response):
|
||||
driver: PlaywrightDriver = response.driver
|
||||
page: Page = driver.page
|
||||
|
||||
page.type("#kw", "feapder")
|
||||
page.click("#su")
|
||||
page.wait_for_load_state("networkidle")
|
||||
time.sleep(1)
|
||||
|
||||
html = page.content()
|
||||
response.text = html # 使response加载最新的页面
|
||||
for data_container in response.xpath("//div[@class='c-container']"):
|
||||
print(data_container.xpath("string(.//h3)").extract_first())
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestPlaywright(thread_count=1).run()
|
||||
```
|
||||
@@ -0,0 +1,281 @@
|
||||
# 浏览器渲染-Selenium
|
||||
|
||||
采集动态页面时(Ajax渲染的页面),常用的有两种方案。一种是找接口拼参数,这种方式比较复杂但效率高,需要一定的爬虫功底;另外一种是采用浏览器渲染的方式,直接获取源码,简单方便
|
||||
|
||||
框架内置一个浏览器渲染池,默认的池子大小为1,请求时重复利用浏览器实例,只有当代理失效请求异常时,才会销毁、创建一个新的浏览器实例
|
||||
|
||||
内置浏览器渲染支持 **CHROME**、**EDGE**、**PHANTOMJS**、**FIREFOX**
|
||||
|
||||
## 使用方式:
|
||||
|
||||
```python
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://news.qq.com/", render=True)
|
||||
```
|
||||
在返回的Request中传递`render=True`即可
|
||||
|
||||
框架支持`CHROME`、`EDGE`、`PHANTOMJS`、`FIREFOX` 三种浏览器渲染,可通过[配置文件](source_code/配置文件)进行配置。相关配置如下:
|
||||
|
||||
```python
|
||||
# 浏览器渲染
|
||||
WEBDRIVER = dict(
|
||||
pool_size=1, # 浏览器的数量
|
||||
load_images=True, # 是否加载图片
|
||||
user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
headless=False, # 是否为无头浏览器
|
||||
driver_type="CHROME", # CHROME、EDGE、PHANTOMJS、FIREFOX
|
||||
timeout=30, # 请求超时时间
|
||||
window_size=(1024, 800), # 窗口大小
|
||||
executable_path=None, # 浏览器路径,默认为默认路径
|
||||
render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
custom_argument=["--ignore-certificate-errors"], # 自定义浏览器渲染参数
|
||||
xhr_url_regexes=None, # 拦截xhr接口,支持正则,数组类型
|
||||
auto_install_driver=False, # 自动下载浏览器驱动 支持chrome 和 firefox
|
||||
)
|
||||
```
|
||||
|
||||
- `feapder.Request` 也支持`render_time`参数, 优先级大于配置文件中的`render_time`
|
||||
|
||||
- 代理使用优先级:`feapder.Request`指定的代理 > 配置文件中的`PROXY_EXTRACT_API` > webdriver配置文件中的`proxy`
|
||||
|
||||
- user_agent使用优先级:`feapder.Request`指定的header里的`User-Agent` > 框架随机的`User-Agent` > webdriver配置文件中的`user_agent`
|
||||
|
||||
## 设置User-Agent
|
||||
|
||||
> 每次生成一个新的浏览器实例时生效
|
||||
|
||||
### 方式1:
|
||||
|
||||
通过配置文件的 `user_agent` 参数设置
|
||||
|
||||
### 方式2:
|
||||
|
||||
通过 `feapder.Request`携带,优先级大于配置文件, 如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.headers = {
|
||||
"User-Agent": "xxxxxxxx"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
## 设置代理
|
||||
|
||||
> 每次生成一个新的浏览器实例时生效
|
||||
|
||||
### 方式1:
|
||||
|
||||
通过配置文件的 `proxy` 参数设置
|
||||
|
||||
### 方式2:
|
||||
|
||||
通过 `feapder.Request`携带,优先级大于配置文件, 如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.proxies = {
|
||||
"https": "https://xxx.xxx.xxx.xxx:xxxx"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
## 设置Cookie
|
||||
|
||||
通过 `feapder.Request`携带,如:
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.headers = {
|
||||
"Cookie": "key=value; key2=value2"
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
或者
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.cookies = {
|
||||
"key": "value",
|
||||
"key2": "value2",
|
||||
}
|
||||
return request
|
||||
```
|
||||
|
||||
或者
|
||||
|
||||
```python
|
||||
def download_midware(self, request):
|
||||
request.cookies = [
|
||||
{
|
||||
"domain": "xxx",
|
||||
"name": "xxx",
|
||||
"value": "xxx",
|
||||
"expirationDate": "xxx"
|
||||
},
|
||||
]
|
||||
return request
|
||||
```
|
||||
|
||||
## 操作浏览器对象
|
||||
|
||||
通过 `response.browser` 获取浏览器对象
|
||||
|
||||
代码示例:请求百度,搜索feapder
|
||||
|
||||
```python
|
||||
import time
|
||||
|
||||
import feapder
|
||||
from feapder.utils.webdriver import WebDriver
|
||||
|
||||
|
||||
class TestRender(feapder.AirSpider):
|
||||
def start_requests(self):
|
||||
yield feapder.Request("http://www.baidu.com", render=True)
|
||||
|
||||
def parse(self, request, response):
|
||||
browser: WebDriver = response.browser
|
||||
browser.find_element_by_id("kw").send_keys("feapder")
|
||||
browser.find_element_by_id("su").click()
|
||||
time.sleep(5)
|
||||
print(browser.page_source)
|
||||
|
||||
# response也是可以正常使用的
|
||||
# response.xpath("//title")
|
||||
|
||||
# 若有滚动,可通过如下方式更新response,使其加载滚动后的内容
|
||||
# response.text = browser.page_source
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestRender().start()
|
||||
|
||||
```
|
||||
|
||||
## 拦截xhr数据
|
||||
|
||||
### 设置拦截规则
|
||||
|
||||
```python
|
||||
WEBDRIVER = dict(
|
||||
...
|
||||
xhr_url_regexes=[
|
||||
"接口1正则",
|
||||
"接口2正则",
|
||||
]
|
||||
)
|
||||
```
|
||||
|
||||
### 获取数据
|
||||
|
||||
```python
|
||||
browser: WebDriver = response.browser
|
||||
text = browser.xhr_text("接口1正则")
|
||||
```
|
||||
|
||||
### 获取json格式数据
|
||||
|
||||
```python
|
||||
browser: WebDriver = response.browser
|
||||
data = browser.xhr_json("接口1正则")
|
||||
```
|
||||
|
||||
### 获取response
|
||||
|
||||
```python
|
||||
browser: WebDriver = response.browser
|
||||
xhr_response = browser.xhr_response("接口1正则")
|
||||
print("请求接口", xhr_response.request.url)
|
||||
print("请求头", xhr_response.request.headers)
|
||||
print("请求体", xhr_response.request.data)
|
||||
print("返回头", xhr_response.headers)
|
||||
print("返回地址", xhr_response.url)
|
||||
print("返回内容", xhr_response.content)
|
||||
```
|
||||
|
||||
|
||||
### 示例:
|
||||
|
||||
需求:
|
||||

|
||||
|
||||
代码:
|
||||
|
||||
```python
|
||||
import time
|
||||
|
||||
import feapder
|
||||
from feapder.utils.webdriver import WebDriver
|
||||
|
||||
|
||||
class TestRender(feapder.AirSpider):
|
||||
__custom_setting__ = dict(
|
||||
WEBDRIVER=dict(
|
||||
pool_size=1, # 浏览器的数量
|
||||
load_images=True, # 是否加载图片
|
||||
user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
headless=False, # 是否为无头浏览器
|
||||
driver_type="CHROME", # CHROME、EDGE、PHANTOMJS、FIREFOX
|
||||
timeout=30, # 请求超时时间
|
||||
window_size=(1024, 800), # 窗口大小
|
||||
executable_path=None, # 浏览器路径,默认为默认路径
|
||||
render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
custom_argument=["--ignore-certificate-errors"], # 自定义浏览器渲染参数
|
||||
xhr_url_regexes=[
|
||||
"/ad",
|
||||
], # 拦截 http://www.spidertools.cn/spidertools/ad 接口
|
||||
)
|
||||
)
|
||||
|
||||
def start_requests(self):
|
||||
yield feapder.Request("http://www.spidertools.cn", render=True)
|
||||
|
||||
def parse(self, request, response):
|
||||
browser: WebDriver = response.browser
|
||||
time.sleep(3)
|
||||
|
||||
# 获取接口数据 文本类型
|
||||
ad = browser.xhr_text("/ad")
|
||||
print(ad)
|
||||
|
||||
# 获取接口数据 转成json,本例因为返回的接口是文本,所以不转了
|
||||
# browser.xhr_json("/ad")
|
||||
|
||||
xhr_response = browser.xhr_response("/ad")
|
||||
print("请求接口", xhr_response.request.url)
|
||||
# 请求头目前获取的不完整
|
||||
print("请求头", xhr_response.request.headers)
|
||||
print("请求体", xhr_response.request.data)
|
||||
print("返回头", xhr_response.headers)
|
||||
print("返回地址", xhr_response.url)
|
||||
print("返回内容", xhr_response.content)
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestRender().start()
|
||||
|
||||
```
|
||||
|
||||
## 驱动版本自动适配
|
||||
|
||||
```python
|
||||
WEBDRIVER = dict(
|
||||
...
|
||||
auto_install_driver=True
|
||||
)
|
||||
```
|
||||
|
||||
即浏览器渲染相关配置 `auto_install_driver` 设置True,让其自动对比驱动版本,版本不符或驱动不存在时自动下载
|
||||
|
||||
## 关闭当前浏览器
|
||||
|
||||
```python
|
||||
def parse(self, request, response):
|
||||
response.close_browser(request)
|
||||
```
|
||||
|
||||
关闭会自动重开一个新的浏览器实例
|
||||
@@ -0,0 +1,94 @@
|
||||
# 监控打点
|
||||
|
||||
需配合爬虫管理系统 **feaplat**
|
||||
|
||||
监控数据默认保留180天,滚动删除
|
||||
|
||||
## 爬虫中使用
|
||||
|
||||
> 需feapder>=1.6.6
|
||||
|
||||
feapder内置了监控打点,只需要部署到feaplat爬虫管理系统即可实现对请求和数据监控
|
||||
|
||||

|
||||
|
||||
- 注意使用 `yield item` 的方式入库的数据,才能看到数据监控的指标,图表的title是表名,折线图展示了每个字段是否有值的情况以及数据总量(total count)
|
||||
|
||||
- document为下载情况
|
||||
|
||||
若想监控些其他的指标,参考自定义监控:
|
||||
|
||||
|
||||
## 自定义监控
|
||||
|
||||
举例:编写`test_metrics.py`代码如下:
|
||||
|
||||
```python
|
||||
from feapder.utils import metrics
|
||||
|
||||
# 初始化打点系统
|
||||
metrics.init()
|
||||
|
||||
metrics.emit_counter("key", count=1, classify="test")
|
||||
|
||||
metrics.close()
|
||||
```
|
||||
|
||||
部署到feaplat:
|
||||
|
||||

|
||||
|
||||
查看监控:
|
||||
|
||||

|
||||
|
||||
再来解释下
|
||||
```
|
||||
metrics.emit_counter("key", count=1, classify="test")
|
||||
```
|
||||
- key 对应上图中的折线
|
||||
- count 对应上图中的点数
|
||||
- classify 对应上图中的图表标题
|
||||
|
||||
若代码如下:
|
||||
```python
|
||||
from feapder.utils import metrics
|
||||
|
||||
# 初始化打点系统
|
||||
metrics.init()
|
||||
|
||||
metrics.emit_counter("key", count=1, classify="test")
|
||||
metrics.emit_counter("key2", count=1, classify="test")
|
||||
metrics.emit_counter("key3", count=1, classify="test")
|
||||
|
||||
metrics.emit_counter("哈哈", count=1, classify="test2")
|
||||
|
||||
metrics.close()
|
||||
```
|
||||
|
||||
应该生成两张图表,第一个图表3条折线,实际生成如下:
|
||||
|
||||

|
||||
|
||||
|
||||
如在feapder爬虫中使用,示例如下:
|
||||
|
||||
```python
|
||||
import feapder
|
||||
from feapder.utils import metrics
|
||||
|
||||
|
||||
class TestSpider(feapder.AirSpider):
|
||||
def start_requests(self):
|
||||
yield feapder.Request("https://www.baidu.com")
|
||||
|
||||
def parse(self, request, response):
|
||||
# 自定义监控
|
||||
metrics.emit_counter("success", count=1, classify="自定义的监控指标")
|
||||
|
||||
|
||||
if __name__ == "__main__":
|
||||
TestSpider().start()
|
||||
```
|
||||
|
||||
我们只需要导包,然后`metrics.emit_counter`即可,不需要关心 `metrics.init`和`metrics.close`, 若在scrapy或其他python脚本中使用,必须调用`metrics.init`和`metrics.close`
|
||||
@@ -0,0 +1,211 @@
|
||||
# 配置文件
|
||||
|
||||
配置文件支持全局配置及某个爬虫自定义配置
|
||||
|
||||
## 全局配置
|
||||
|
||||
在项目的根目录下创建 setting.py, 全部的参数如下,按需选择
|
||||

|
||||
|
||||
```python
|
||||
# -*- coding: utf-8 -*-
|
||||
"""爬虫配置文件"""
|
||||
# import os
|
||||
# import sys
|
||||
#
|
||||
# # MYSQL
|
||||
# MYSQL_IP = "localhost"
|
||||
# MYSQL_PORT = 3306
|
||||
# MYSQL_DB = ""
|
||||
# MYSQL_USER_NAME = ""
|
||||
# MYSQL_USER_PASS = ""
|
||||
#
|
||||
# # MONGODB
|
||||
# MONGO_IP = "localhost"
|
||||
# MONGO_PORT = 27017
|
||||
# MONGO_DB = ""
|
||||
# MONGO_USER_NAME = ""
|
||||
# MONGO_USER_PASS = ""
|
||||
#
|
||||
# # REDIS
|
||||
# # ip:port 多个可写为列表或者逗号隔开 如 ip1:port1,ip2:port2 或 ["ip1:port1", "ip2:port2"]
|
||||
# REDISDB_IP_PORTS = "localhost:6379"
|
||||
# REDISDB_USER_PASS = ""
|
||||
# REDISDB_DB = 0
|
||||
# # 适用于redis哨兵模式
|
||||
# REDISDB_SERVICE_NAME = ""
|
||||
#
|
||||
# # 数据入库的pipeline,可自定义,默认MysqlPipeline
|
||||
# ITEM_PIPELINES = [
|
||||
# "feapder.pipelines.mysql_pipeline.MysqlPipeline",
|
||||
# # "feapder.pipelines.mongo_pipeline.MongoPipeline",
|
||||
# # "feapder.pipelines.console_pipeline.ConsolePipeline",
|
||||
# ]
|
||||
# EXPORT_DATA_MAX_FAILED_TIMES = 10 # 导出数据时最大的失败次数,包括保存和更新,超过这个次数报警
|
||||
# EXPORT_DATA_MAX_RETRY_TIMES = 10 # 导出数据时最大的重试次数,包括保存和更新,超过这个次数则放弃重试
|
||||
#
|
||||
# # 爬虫相关
|
||||
# # COLLECTOR
|
||||
# COLLECTOR_TASK_COUNT = 32 # 每次获取任务数量,追求速度推荐32
|
||||
#
|
||||
# # SPIDER
|
||||
# SPIDER_THREAD_COUNT = 1 # 爬虫并发数,追求速度推荐32
|
||||
# # 下载时间间隔 单位秒。 支持随机 如 SPIDER_SLEEP_TIME = [2, 5] 则间隔为 2~5秒之间的随机数,包含2和5
|
||||
# SPIDER_SLEEP_TIME = 0
|
||||
# SPIDER_MAX_RETRY_TIMES = 10 # 每个请求最大重试次数
|
||||
# KEEP_ALIVE = False # 爬虫是否常驻
|
||||
|
||||
# 下载
|
||||
# DOWNLOADER = "feapder.network.downloader.RequestsDownloader"
|
||||
# SESSION_DOWNLOADER = "feapder.network.downloader.RequestsSessionDownloader"
|
||||
# RENDER_DOWNLOADER = "feapder.network.downloader.SeleniumDownloader"
|
||||
# # RENDER_DOWNLOADER="feapder.network.downloader.PlaywrightDownloader",
|
||||
# MAKE_ABSOLUTE_LINKS = True # 自动转成绝对连接
|
||||
|
||||
# # 浏览器渲染
|
||||
# WEBDRIVER = dict(
|
||||
# pool_size=1, # 浏览器的数量
|
||||
# load_images=True, # 是否加载图片
|
||||
# user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
# proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
# headless=False, # 是否为无头浏览器
|
||||
# driver_type="CHROME", # CHROME、EDGE、PHANTOMJS、FIREFOX
|
||||
# timeout=30, # 请求超时时间
|
||||
# window_size=(1024, 800), # 窗口大小
|
||||
# executable_path=None, # 浏览器路径,默认为默认路径
|
||||
# render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
# custom_argument=[
|
||||
# "--ignore-certificate-errors",
|
||||
# "--disable-blink-features=AutomationControlled",
|
||||
# ], # 自定义浏览器渲染参数
|
||||
# xhr_url_regexes=None, # 拦截xhr接口,支持正则,数组类型
|
||||
# auto_install_driver=True, # 自动下载浏览器驱动 支持chrome 和 firefox
|
||||
# download_path=None, # 下载文件的路径
|
||||
# use_stealth_js=False, # 使用stealth.min.js隐藏浏览器特征
|
||||
# )
|
||||
#
|
||||
# PLAYWRIGHT = dict(
|
||||
# user_agent=None, # 字符串 或 无参函数,返回值为user_agent
|
||||
# proxy=None, # xxx.xxx.xxx.xxx:xxxx 或 无参函数,返回值为代理地址
|
||||
# headless=False, # 是否为无头浏览器
|
||||
# driver_type="chromium", # chromium、firefox、webkit
|
||||
# timeout=30, # 请求超时时间
|
||||
# window_size=(1024, 800), # 窗口大小
|
||||
# executable_path=None, # 浏览器路径,默认为默认路径
|
||||
# download_path=None, # 下载文件的路径
|
||||
# render_time=0, # 渲染时长,即打开网页等待指定时间后再获取源码
|
||||
# wait_until="networkidle", # 等待页面加载完成的事件,可选值:"commit", "domcontentloaded", "load", "networkidle"
|
||||
# use_stealth_js=False, # 使用stealth.min.js隐藏浏览器特征
|
||||
# page_on_event_callback=None, # page.on() 事件的回调 如 page_on_event_callback={"dialog": lambda dialog: dialog.accept()}
|
||||
# storage_state_path=None, # 保存浏览器状态的路径
|
||||
# url_regexes=None, # 拦截接口,支持正则,数组类型
|
||||
# save_all=False, # 是否保存所有拦截的接口, 配合url_regexes使用,为False时只保存最后一次拦截的接口
|
||||
# )
|
||||
#
|
||||
# # 爬虫启动时,重新抓取失败的requests
|
||||
# RETRY_FAILED_REQUESTS = False
|
||||
# # 保存失败的request
|
||||
# SAVE_FAILED_REQUEST = True
|
||||
# # request防丢机制。(指定的REQUEST_LOST_TIMEOUT时间内request还没做完,会重新下发 重做)
|
||||
# REQUEST_LOST_TIMEOUT = 600 # 10分钟
|
||||
# # request网络请求超时时间
|
||||
# REQUEST_TIMEOUT = 22 # 等待服务器响应的超时时间,浮点数,或(connect timeout, read timeout)元组
|
||||
# # item在内存队列中最大缓存数量
|
||||
# ITEM_MAX_CACHED_COUNT = 5000
|
||||
# # item每批入库的最大数量
|
||||
# ITEM_UPLOAD_BATCH_MAX_SIZE = 1000
|
||||
# # item入库时间间隔
|
||||
# ITEM_UPLOAD_INTERVAL = 1
|
||||
# # 内存任务队列最大缓存的任务数,默认不限制;仅对AirSpider有效。
|
||||
# TASK_MAX_CACHED_SIZE = 0
|
||||
#
|
||||
# # 下载缓存 利用redis缓存,但由于内存大小限制,所以建议仅供开发调试代码时使用,防止每次debug都需要网络请求
|
||||
# RESPONSE_CACHED_ENABLE = False # 是否启用下载缓存 成本高的数据或容易变需求的数据,建议设置为True
|
||||
# RESPONSE_CACHED_EXPIRE_TIME = 3600 # 缓存时间 秒
|
||||
# RESPONSE_CACHED_USED = False # 是否使用缓存 补采数据时可设置为True
|
||||
#
|
||||
# # 设置代理
|
||||
# PROXY_EXTRACT_API = None # 代理提取API ,返回的代理分割符为\r\n
|
||||
# PROXY_ENABLE = True
|
||||
#
|
||||
# # 随机headers
|
||||
# RANDOM_HEADERS = True
|
||||
# # UserAgent类型 支持 'chrome', 'opera', 'firefox', 'internetexplorer', 'safari','mobile' 若不指定则随机类型
|
||||
# USER_AGENT_TYPE = "chrome"
|
||||
# # 默认使用的浏览器头
|
||||
# DEFAULT_USERAGENT = "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_2) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.103 Safari/537.36"
|
||||
# # requests 使用session
|
||||
# USE_SESSION = False
|
||||
#
|
||||
# # 去重
|
||||
# ITEM_FILTER_ENABLE = False # item 去重
|
||||
# REQUEST_FILTER_ENABLE = False # request 去重
|
||||
# ITEM_FILTER_SETTING = dict(
|
||||
# filter_type=1 # 永久去重(BloomFilter) = 1 、内存去重(MemoryFilter) = 2、 临时去重(ExpireFilter)= 3、轻量去重(LiteFilter)= 4
|
||||
# )
|
||||
# REQUEST_FILTER_SETTING = dict(
|
||||
# filter_type=3, # 永久去重(BloomFilter) = 1 、内存去重(MemoryFilter) = 2、 临时去重(ExpireFilter)= 3、 轻量去重(LiteFilter)= 4
|
||||
# expire_time=2592000, # 过期时间1个月
|
||||
# )
|
||||
#
|
||||
# # 报警 支持钉钉、飞书、企业微信、邮件
|
||||
# # 钉钉报警
|
||||
# DINGDING_WARNING_URL = "" # 钉钉机器人api
|
||||
# DINGDING_WARNING_PHONE = "" # 报警人 支持列表,可指定多个
|
||||
# DINGDING_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
# # 飞书报警
|
||||
# # https://open.feishu.cn/document/ukTMukTMukTM/ucTM5YjL3ETO24yNxkjN#e1cdee9f
|
||||
# FEISHU_WARNING_URL = "" # 飞书机器人api
|
||||
# FEISHU_WARNING_USER = None # 报警人 {"open_id":"ou_xxxxx", "name":"xxxx"} 或 [{"open_id":"ou_xxxxx", "name":"xxxx"}]
|
||||
# FEISHU_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
# # 邮件报警
|
||||
# EMAIL_SENDER = "" # 发件人
|
||||
# EMAIL_PASSWORD = "" # 授权码
|
||||
# EMAIL_RECEIVER = "" # 收件人 支持列表,可指定多个
|
||||
# EMAIL_SMTPSERVER = "smtp.163.com" # 邮件服务器 默认为163邮箱
|
||||
# # 企业微信报警
|
||||
# WECHAT_WARNING_URL = "" # 企业微信机器人api
|
||||
# WECHAT_WARNING_PHONE = "" # 报警人 将会在群内@此人, 支持列表,可指定多人
|
||||
# WECHAT_WARNING_ALL = False # 是否提示所有人, 默认为False
|
||||
# # 时间间隔
|
||||
# WARNING_INTERVAL = 3600 # 相同报警的报警时间间隔,防止刷屏; 0表示不去重
|
||||
# WARNING_LEVEL = "DEBUG" # 报警级别, DEBUG / INFO / ERROR
|
||||
# WARNING_FAILED_COUNT = 1000 # 任务失败数 超过WARNING_FAILED_COUNT则报警
|
||||
#
|
||||
# LOG_NAME = os.path.basename(os.getcwd())
|
||||
# LOG_PATH = "log/%s.log" % LOG_NAME # log存储路径
|
||||
# LOG_LEVEL = "DEBUG"
|
||||
# LOG_COLOR = True # 是否带有颜色
|
||||
# LOG_IS_WRITE_TO_CONSOLE = True # 是否打印到控制台
|
||||
# LOG_IS_WRITE_TO_FILE = False # 是否写文件
|
||||
# LOG_MODE = "w" # 写文件的模式
|
||||
# LOG_MAX_BYTES = 10 * 1024 * 1024 # 每个日志文件的最大字节数
|
||||
# LOG_BACKUP_COUNT = 20 # 日志文件保留数量
|
||||
# LOG_ENCODING = "utf8" # 日志文件编码
|
||||
# OTHERS_LOG_LEVAL = "ERROR" # 第三方库的log等级
|
||||
#
|
||||
# # 切换工作路径为当前项目路径
|
||||
# project_path = os.path.abspath(os.path.dirname(__file__))
|
||||
# os.chdir(project_path) # 切换工作路经
|
||||
# sys.path.insert(0, project_path)
|
||||
# print("当前工作路径为 " + os.getcwd())
|
||||
|
||||
```
|
||||
|
||||
- 数据库连接信息默认读取的环境变量,因此若不想将自己的账号暴露给其他同事,建议写在环境变量里,环境变量的`key`与配置文件的`key`相同
|
||||
|
||||
- `LOG_LEVEL`为`DEBUG`时,日志输出比较详细,开发阶段使用。线上部署时,可将`LOG_LEVEL`改为`INFO`
|
||||
|
||||
## 自定义配置
|
||||
|
||||
常用于一个项目下有多个爬虫,不同的爬虫使用不同的配置。我们可以使用类变量`__custom_setting__`自定义配置,示例如下:
|
||||
|
||||
```python
|
||||
import feapder
|
||||
|
||||
|
||||
class SpiderTest(feapder.AirSpider):
|
||||
__custom_setting__ = dict(
|
||||
SPIDER_MAX_RETRY_TIMES=20,
|
||||
)
|
||||
```
|
||||
Reference in New Issue
Block a user